SHA-256(也常寫成 SHA256)是一種雜湊演算法,能把任何大小的資料轉換成固定 256 位元的摘要,用來檢查資料有沒有被更動。本文從雜湊值的概念出發,整理 SHA-256 的歷史、運作方式、四大特性、雜湊碰撞與主要用途,也是學習 AI 程式設計時值得先弄懂的基礎觀念。
一、SHA-256 是什麼?為什麼需要雜湊演算法?
SHA-256 是 SHA-2 家族中的一種雜湊演算法,作用是替任何資料產生一組固定長度的摘要,讓人能檢查資料有沒有被更動。從網路上下載一個軟體安裝檔,或是把一份很大的 Excel 檔案寄給同事,檔案傳到對方手上之後,要怎麼確定它跟原本那一份完全一樣?一個字元都沒有少,也沒有被誰改過?如果只能靠人眼開啟比對,檔案小的時候還勉強做得到,一旦檔案有幾十 MB、幾百 MB,這件事就幾乎不可能完成。雜湊演算法要解決的就是這個需求:用一小段固定長度的結果,代表整份資料的內容,讓兩邊只要比對這一小段,就能判斷資料是否一致。
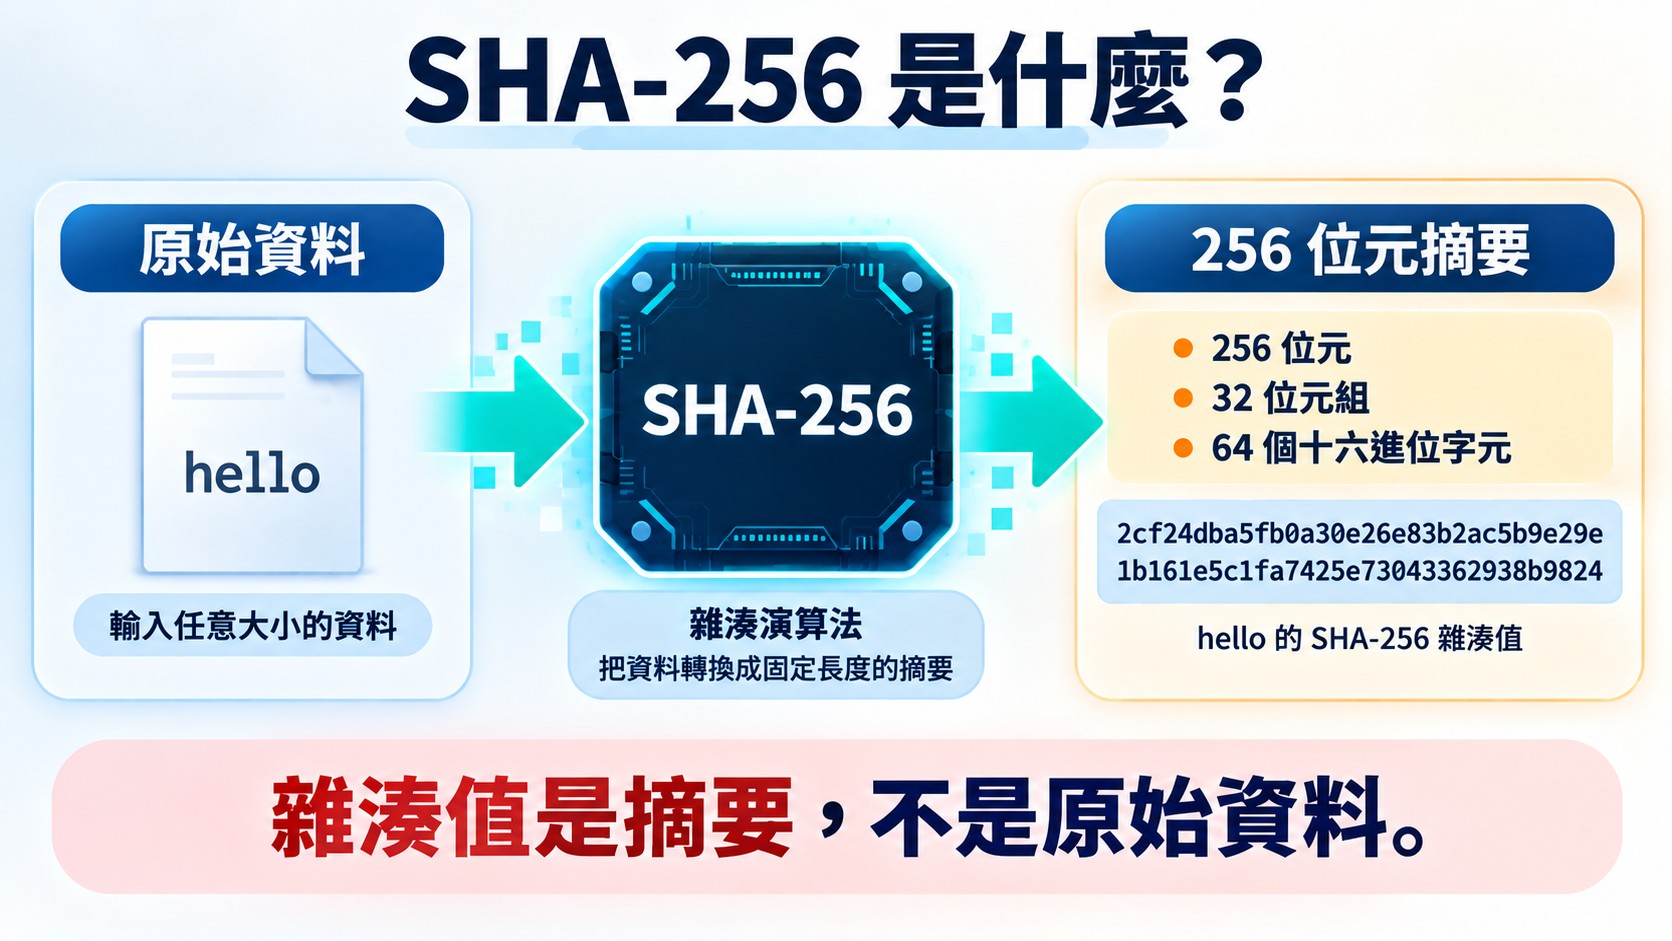
SHA 是 Secure Hash Algorithm 的縮寫,中文通常稱為「安全雜湊演算法」。名稱最後面的 256,指的是演算法輸出結果的長度為 256 位元。雜湊演算法的英文是 Hash Function,輸入任意資料後得到的結果叫做雜湊值(Hash Value),也常稱為摘要(Digest)。整個過程可以簡單理解為:資料進去,演算法計算,一組固定長度的摘要出來。
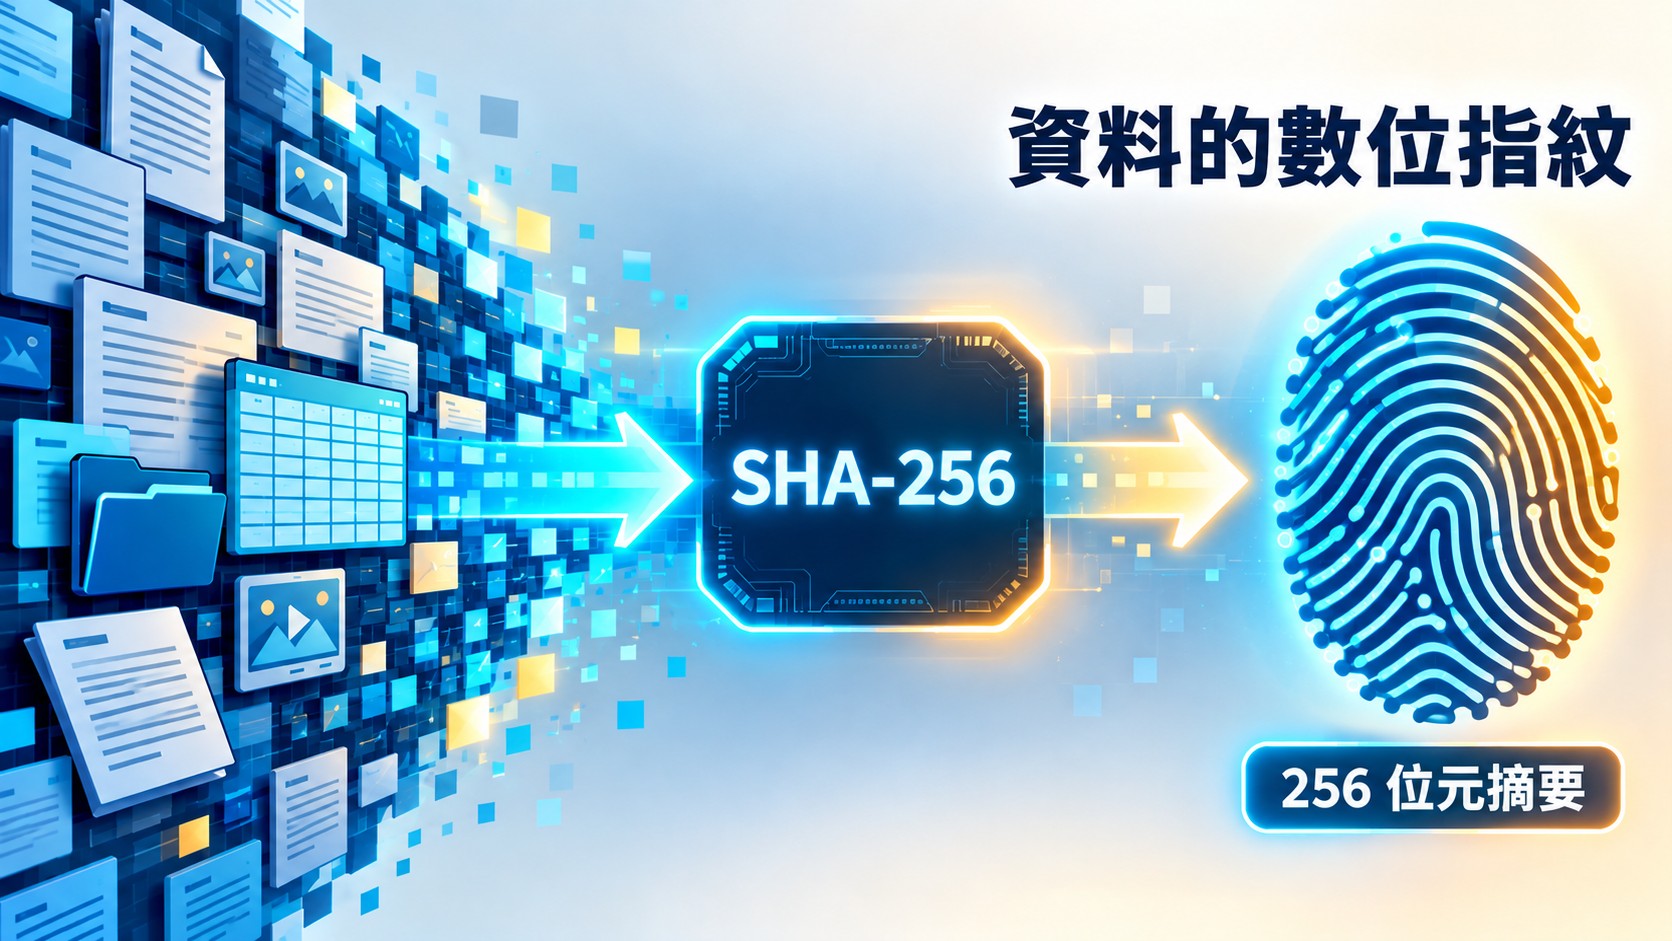
雜湊值就像檔案的數位指紋
256 位元等於 32 個位元組,一般會以 64 個十六進位字元表示。以英文單字 hello 為例,用 SHA-256 計算後的雜湊值如下:
```text
2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824
```
這串看起來沒有任何規律的英數字,就是 hello 這五個字母的 SHA-256 摘要。不論輸入的是一個單字、一份 Excel 檔,還是幾 GB 的影片,輸出的長度都一樣是 64 個十六進位字元。平常說的 SHA256 值,指的就是這一串字元。
因此,雜湊值經常被比喻成檔案的數位指紋:每個人的指紋不同,指紋本身卻遠比一個人小得多,只要指紋對得上,就能高度確定是同一個人。檔案也是如此,即使內容只有很小的變動,通常也會產生截然不同的雜湊值。
二、SHA-256 的發展歷史:NSA 與 NIST 為什麼制定這項標準?
NIST 與 NSA 制定 SHA 系列,是要提供一套公開統一的雜湊標準,用來檢查資料有沒有被更動,也搭配數位簽章使用。簽署一份很大的檔案時,若要直接對全部內容做簽章運算,計算量太大,比較實際的做法是先把檔案縮成一小段摘要,再對摘要簽章。這就要求摘要的產生方式必須公開、統一,並且夠可靠。美國國家標準與技術研究院(NIST)把安全雜湊演算法公布為聯邦資訊處理標準(FIPS),也就是《Secure Hash Standard》,而最早的演算法由美國國家安全局(NSA)設計。
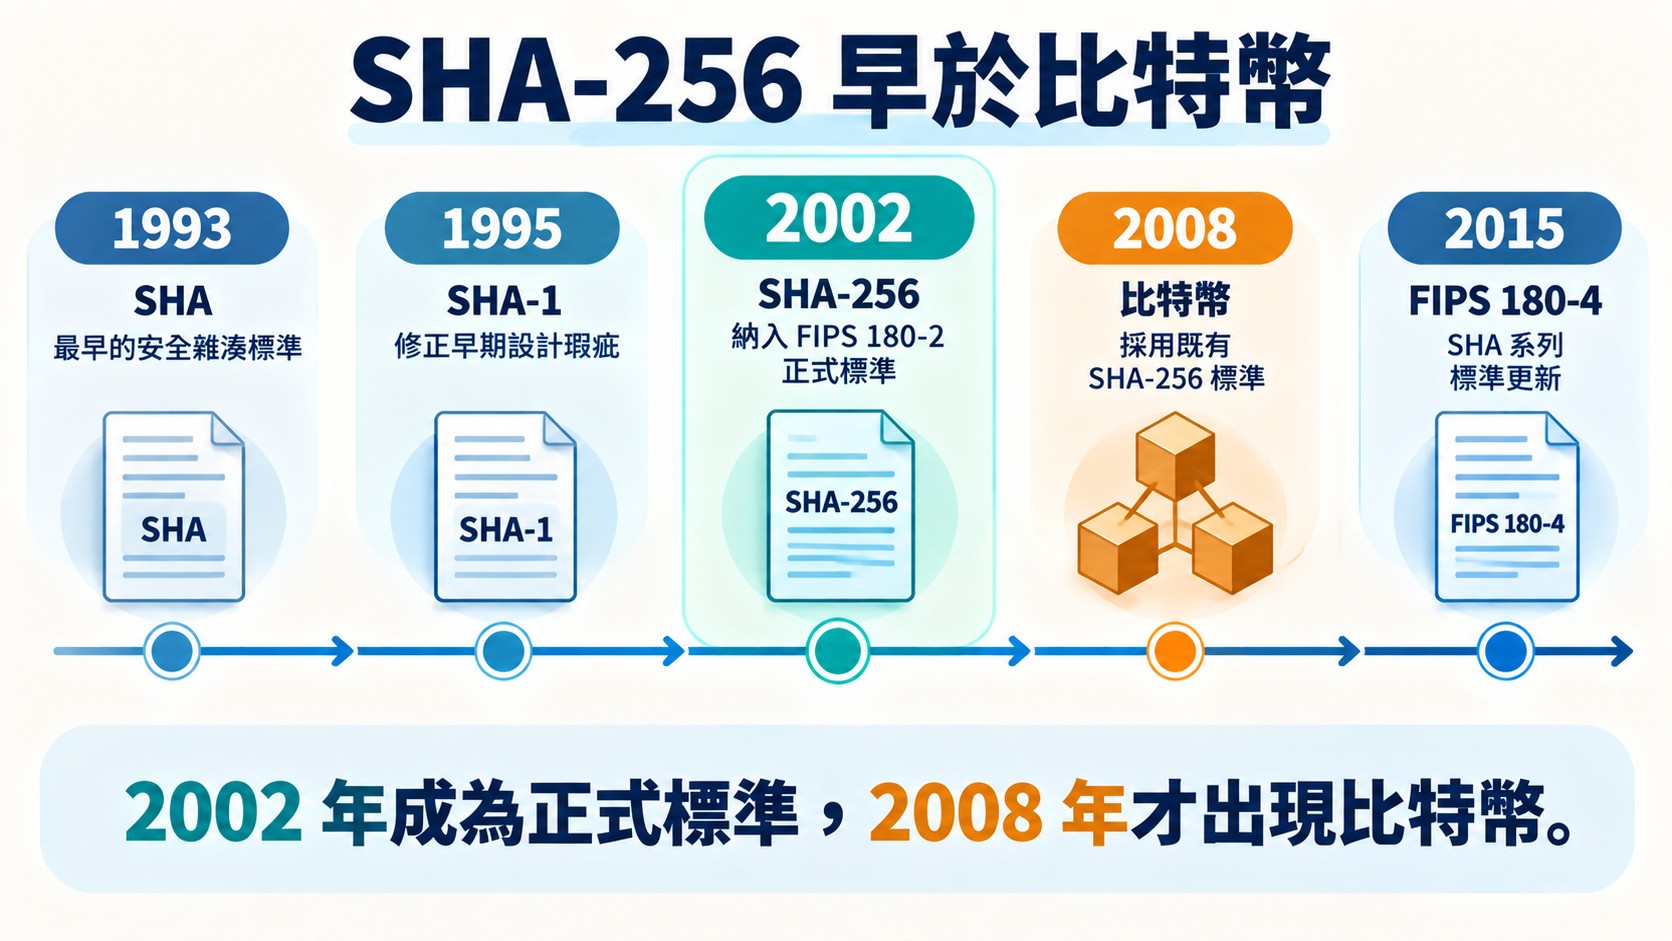
SHA 系列最早的版本在 1993 年發布,後來因為設計上的技術瑕疵,在 1995 年修訂為 SHA-1,輸出長度為 160 位元。2002 年 8 月發布的 FIPS 180-2,把 SHA-256、SHA-384 與 SHA-512 和 SHA-1 一起納入標準,SHA-256 就是在這個版本成為正式標準。2015 年 8 月發布的 FIPS 180-4,則是現行的版本,涵蓋 SHA-1 與 SHA-2 家族的規格。
SHA-1 與 SHA-2 的關係
SHA-2 並不是單一演算法,而是一個家族,包含 SHA-224、SHA-256、SHA-384、SHA-512 等成員,SHA-256 只是其中一員。SHA-256 與 SHA-1 的主要差別,在於輸出長度從 160 位元增加到 256 位元,能提供的安全強度也比較高。
SHA-1 後來被證實存在實際可行的弱點。2017 年,Google 與荷蘭 CWI 研究團隊公開了第一個 SHA-1 碰撞,也就是找出兩份內容不同、卻產生相同 SHA-1 雜湊值的檔案。NIST 在 2011 年已將 SHA-1 列為不建議使用,2013 年底起不得用於數位簽章;NIST 的雜湊函數政策在 2022 年 12 月又公布全面轉換的時程,以 2030 年 12 月 31 日為界,並建議各單位盡快改用 SHA-2 或 SHA-3。相較之下,到目前為止公開資料中還沒有出現 SHA-256 的實際碰撞,SHA-256 也因此成為目前最常被採用的雜湊演算法之一。
SHA-256 並不是為比特幣而發明
不少人是因為比特幣才第一次聽到 SHA-256,容易以為它是為了加密貨幣而設計。事實上,SHA-256 在 2002 年就已經是 NIST 的正式標準,而比特幣是在 2008 年才由中本聰在《比特幣白皮書》中提出的設計。比特幣採用的是一個早已公布的現成標準,而不是它發明了 SHA-256。
三、SHA-256 如何運作?從整份檔案產生 256 位元摘要
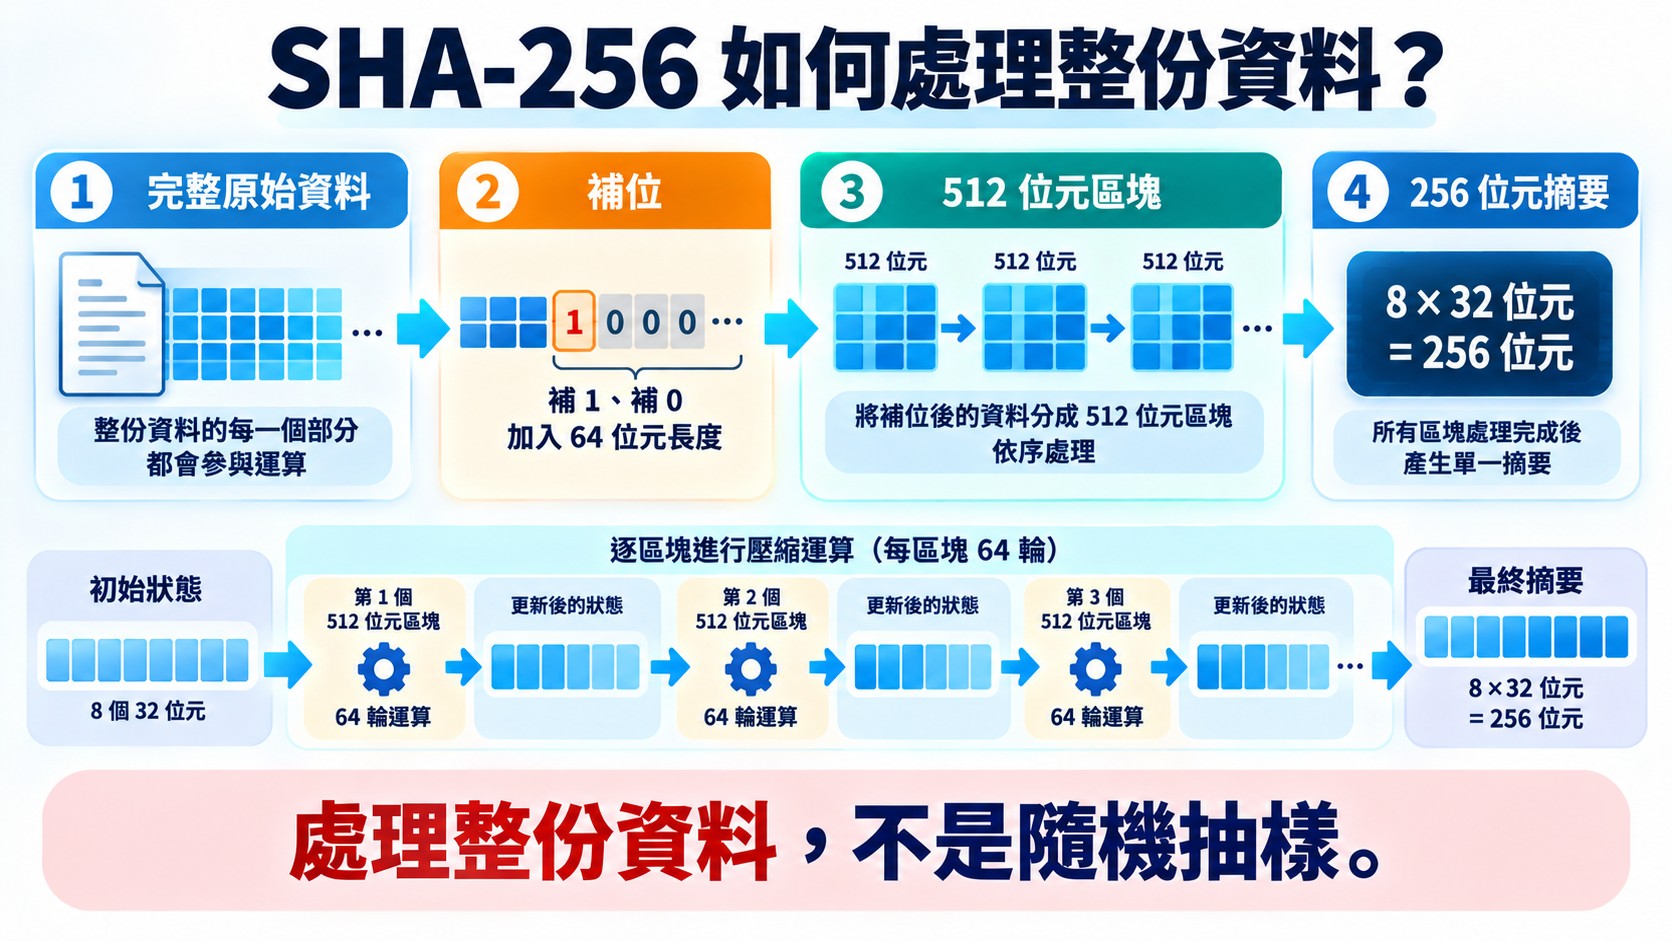
SHA-256 的運作可以簡化成三件事:先把資料補位,再切成 512 位元的區塊逐塊運算,最後把運算結果合成 256 位元的摘要。下面以一份幾十 MB 的大型 Excel 檔案為例,說明這個流程做了什麼。
SHA-256 是處理完整資料,不是隨機抽樣
贊贊小屋第一次接觸 SHA-256 時,原本以為它可能是從檔案裡擷取一部分資料,例如挑開頭、中間、結尾幾段來做運算,再得出一個代表值。後來才理解,SHA-256 處理的是整份資料,檔案裡的每一個位元組都會參與計算。
這件事其實從用途也能反推:如果演算法只抽樣,那麼有人修改了沒被抽到的地方,雜湊值就不會改變,檢查也就失去意義。正因為 SHA-256 會處理完整檔案,無論修改發生在哪個位置,都有機會反映在最後的摘要值上。一般情況下,即使只是很小的資料變動,也會產生截然不同的雜湊值。
為什麼輸出固定為 256 位元
SHA-256 先把整份檔案視為一長串位元,接著在最後補上一些資料:先補一個 1,再補上數量剛好足夠的 0,最後加上記錄原始長度的 64 位元數字,讓總長度剛好是 512 位元的整數倍。這個動作稱為補位。
補位完成後,整份資料會被切成一個個 512 位元的區塊。演算法內部有 8 個各 32 位元的狀態值,起始值是標準中固定的常數。每讀入一個區塊,就會經過 64 輪的運算,把這個區塊的內容混進狀態值裡,運算結果再交給下一個區塊繼續使用。最後一個區塊處理完成後,把 8 個狀態值接在一起,剛好是 8 乘以 32,也就是 256 位元,這就是最終輸出的摘要。
檔案大小只會影響區塊的數量,也就是需要處理幾輪,並不會改變狀態值的數量。所以不論輸入是 1 個字,還是一份幾十 MB 的 Excel 檔,輸出永遠是 256 位元。
四、SHA-256 的四大特性:固定長度、單向性、確定性與雪崩效應
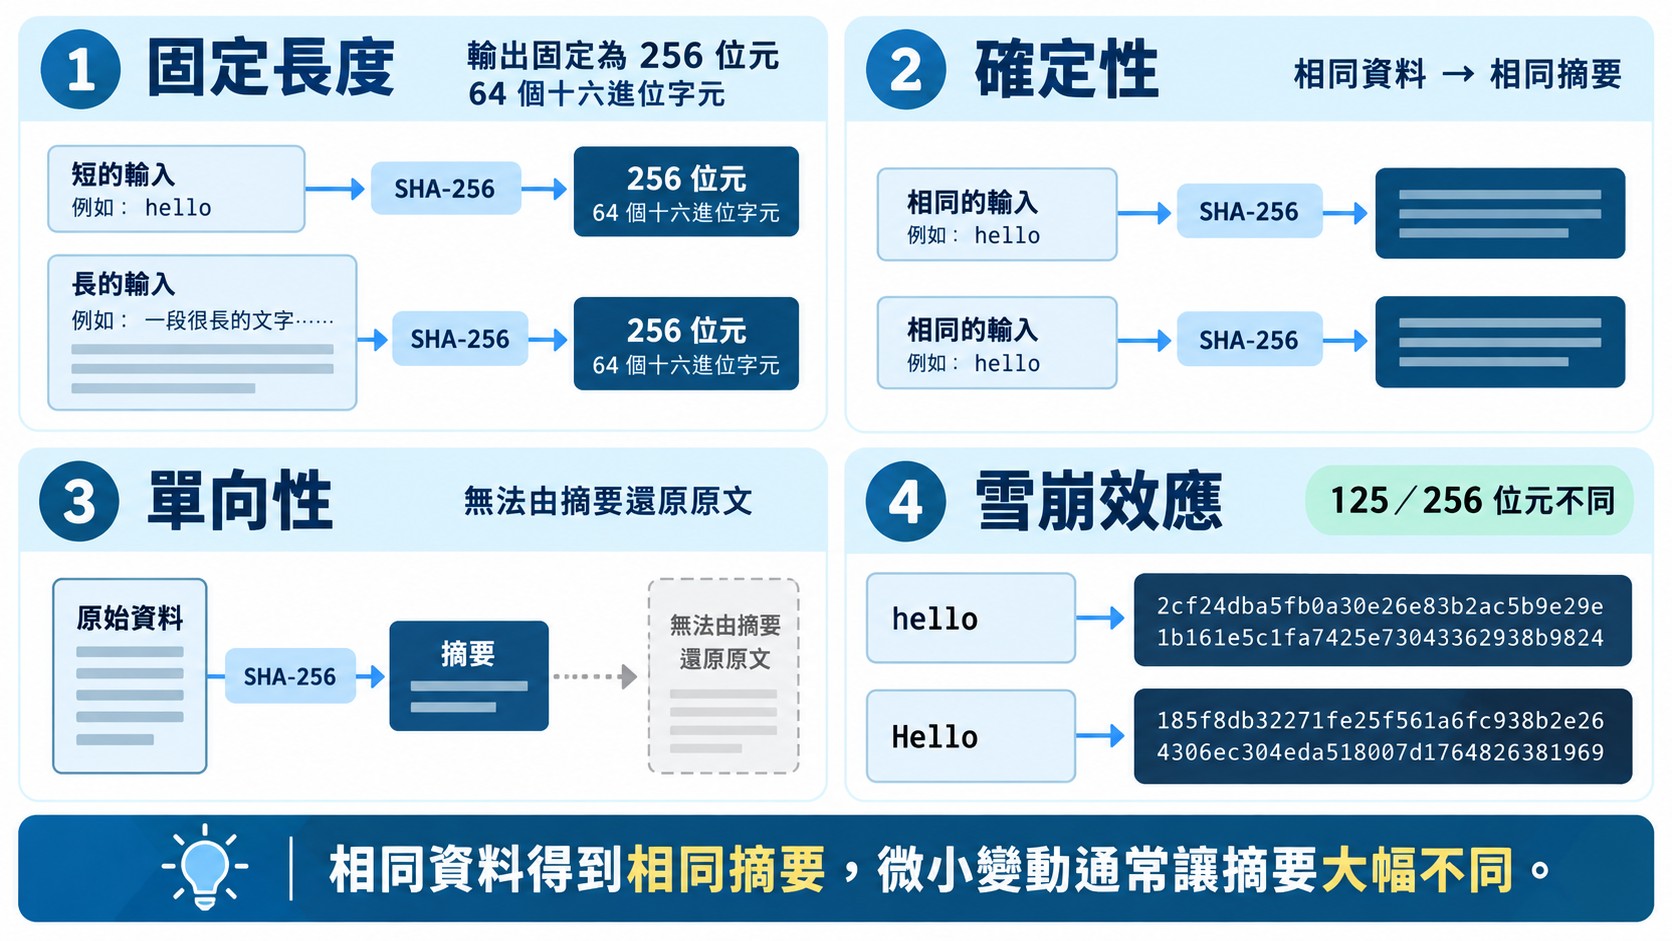
SHA-256 的四大特性是固定長度、確定性、單向性與雪崩效應,這些性質也是它能被拿來檢查資料的原因。
第一個特性是固定長度。不論輸入多大,輸出都是 256 位元。連空字串也有自己的雜湊值,結果以 e3b0c442 開頭,一樣是 64 個十六進位字元。
第二個特性是確定性。相同的輸入,不論在哪一台電腦、哪一個作業系統、用哪一種程式語言計算,得到的結果都完全相同。正因為如此,兩個人才可以各自計算,再比對結果。
第三個特性是單向性。拿到一組雜湊值,很難反推出原本的輸入內容,也沒有一個公式可以讓人把摘要倒推回原文。
第四個特性是雪崩效應:輸入只改變一點點,輸出就會大幅改變。把 hello 的第一個字母改成大寫變成 Hello,雜湊值會變成這樣:
```text
185f8db32271fe25f561a6fc938b2e264306ec304eda518007d1764826381969
```
與前面 hello 的結果相比,找不出任何明顯相似之處。實際比較兩組 256 位元,會發現有 125 位元不同,大約是一半。數字的變化也一樣,「金額 1000」的雜湊值是 ce1ae676 開頭,只把最後一位改成「金額 1001」,結果變成 8cf014be 開頭,完全不同。
SHA-256 是加密嗎?為什麼不能解密還原?
「SHA256 加密」「SHA256 解密」是常見的說法,但嚴格來說,SHA-256 是雜湊,不是加密。加密的目的是把資料藏起來,使用金鑰就能還原;雜湊則沒有金鑰,也不打算還原,它的目的是產生可以比對的摘要。
同樣地,SHA-256 也不是壓縮。壓縮之後的檔案可以解壓縮回原樣,而 256 位元的摘要裡根本沒有儲存原始資料,無法重建。所以「SHA256 可逆嗎」的答案是:不可逆。需要補充的是,如果原文本身很短又很簡單,例如常見的簡單密碼,別人可以把可能的答案一個一個算出來再比對,看起來像是被破解,實際上是猜中,而不是反推。
五、256 位元為什麼能驗證龐大資料?雜湊碰撞是什麼?
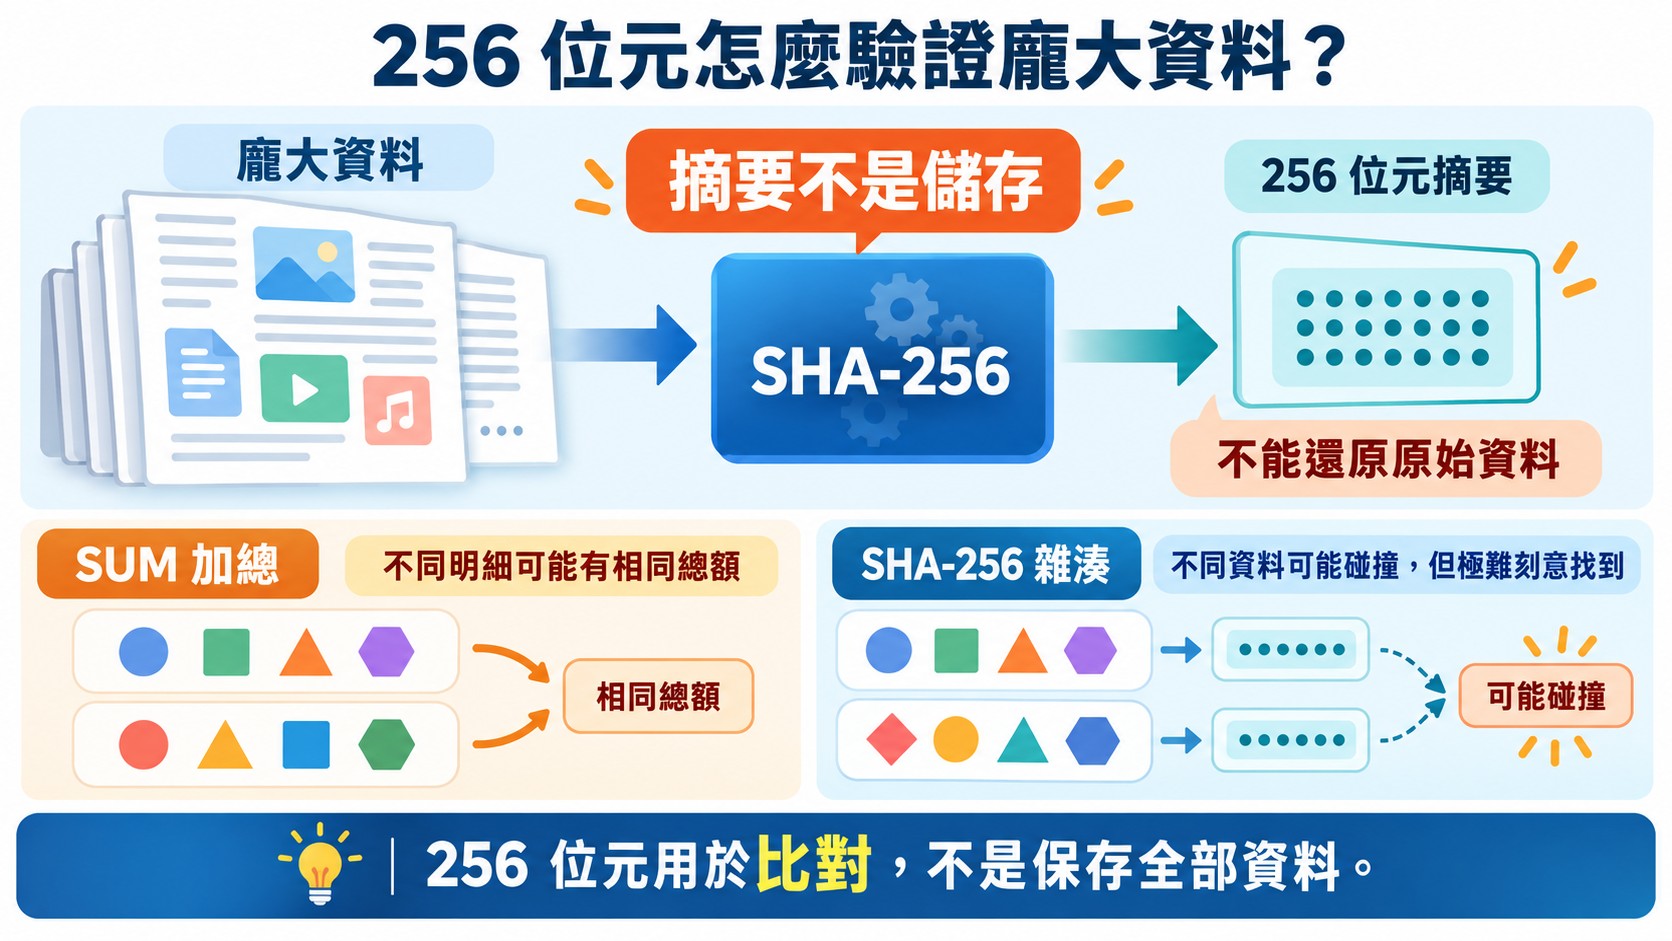
SHA-256 的 256 位元能驗證龐大資料,是因為摘要不是用來儲存資料,而是根據全部內容算出來的特徵值,內容一改,特徵值就跟著改。學到這裡,贊贊小屋曾經有個很直覺的疑問:一份幾十 MB 的大型 Excel 檔案含有上億個位元,竟然只用 256 位元就能代表它,這麼小的摘要,怎麼可能把所有內容都裝進去?
更精確地說,摘要從來就不是用來儲存資料。256 位元裡面並沒有原始檔案的內容,它只是根據全部內容計算出來的一個特徵值。要驗證的時候,不需要從摘要還原資料,只要把檔案重新計算一次,再看新的摘要與原本的摘要是否一致。
這裡有一個無法迴避的數學事實:可能的輸入數量遠遠大於可能的輸出數量。256 位元的輸出共有 2 的 256 次方種可能,約為 1.16 乘以 10 的 77 次方,已經是一個極其龐大的數字,但一個只有 1 MB 的檔案就有超過 800 萬個位元,可能的內容多到無法比較。依照鴿籠原理,把更多的鴿子放進較少的籠子,一定有籠子裡有兩隻以上,換句話說,一定存在兩份不同的資料,產生相同的雜湊值。這種現象稱為雜湊碰撞。
既然碰撞一定存在,為什麼還能用來驗證?重點在於「存在」與「找得到」是兩件事。密碼學雜湊函數的抗碰撞設計,並不是保證不會有碰撞,而是讓人在實際上找不到。NIST 的建議文件指出,SHA-256 抵抗碰撞的強度為 128 位元,意思是要找出任意兩份內容不同、雜湊值卻相同的資料,預期需要約 2 的 128 次方的運算量。另一種情況,是針對一份已知的檔案,找出內容不同、雜湊值卻與它相同的第二份資料,這稱為第二原像問題。有人想改動一份既有的檔案,又要讓摘要與原檔相同,面對的就是這個問題。SHA-256 對一般長度的訊息可提供約 256 位元的第二原像強度,訊息極長時則可能降低,NIST 列出的範圍是 201 到 256 位元。不論是哪一種情況,以目前的計算能力都不可行,因此在一般的檔案檢查裡,被改過的檔案要剛好與原檔得到相同摘要,實務上是做不到的。
用會計的角度比較容易建立直覺。一張報表的總額,並不能還原所有的明細,不同的明細組合可能加出相同總額,但至少總額不對時,代表明細一定有問題。不過,加總與密碼學雜湊還是不同:加總很容易製造相同結果,只要把兩筆金額對調,總額完全不變,而 SHA-256 的設計,則是讓微小的變動通常也會產生截然不同的結果。雖然不同資料在數學上可能出現相同摘要,但要刻意找到這樣的資料,在實務上極為困難。
六、SHA-256 有哪些主要用途?
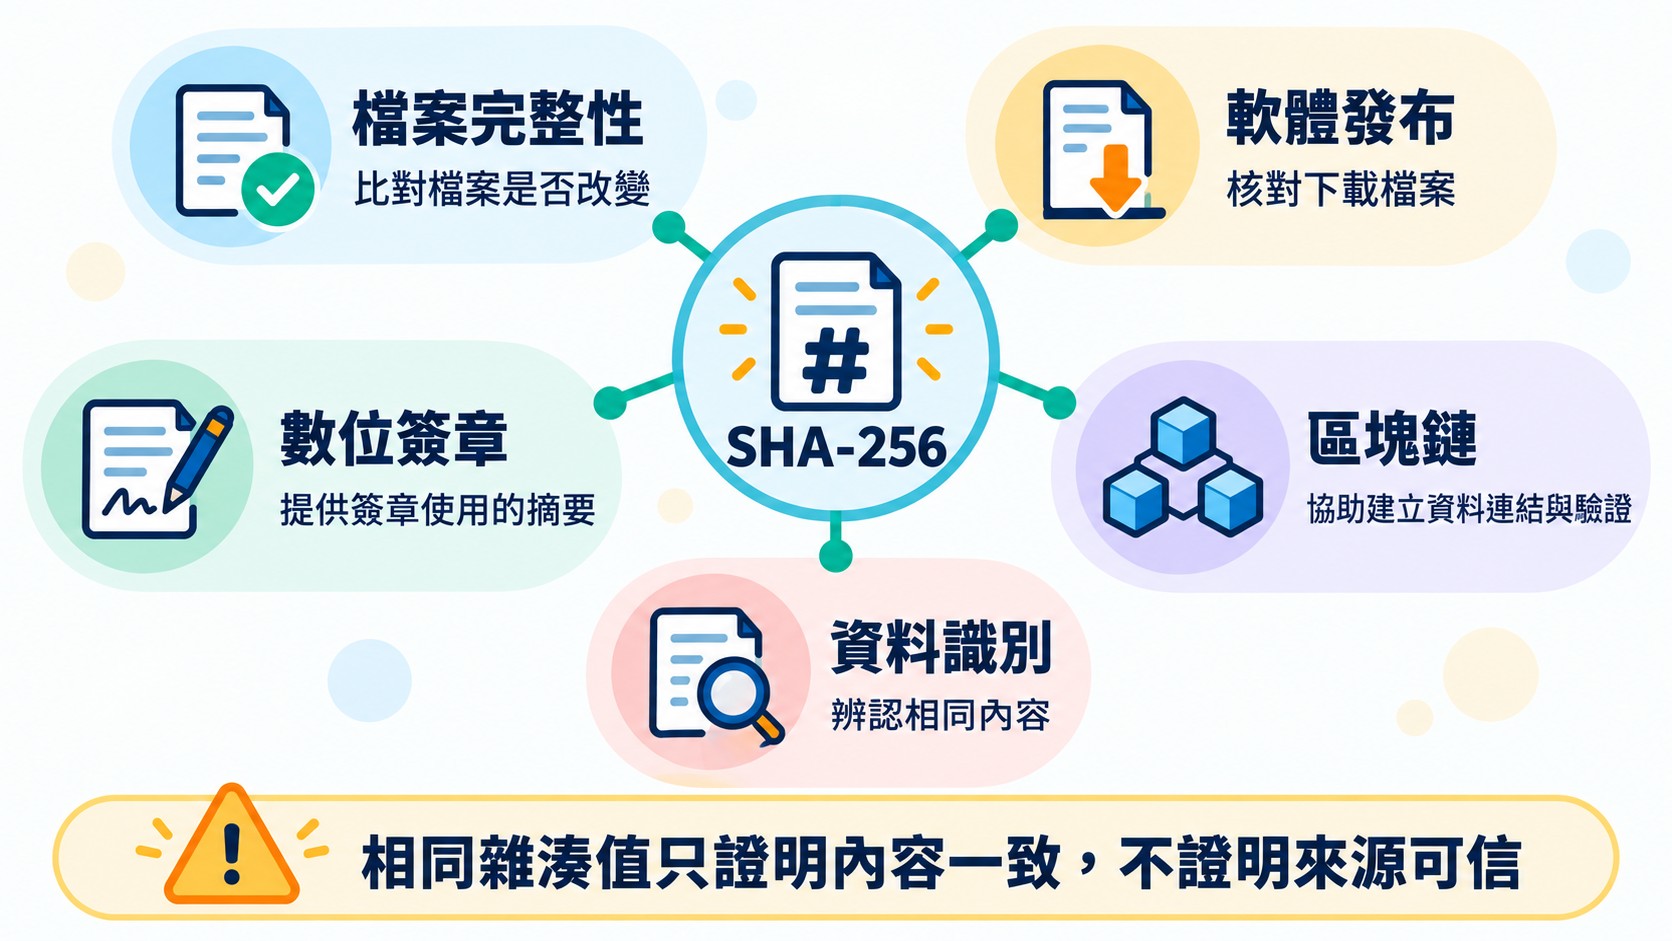
SHA-256 的主要用途包括檔案完整性檢查、軟體發布驗證、數位簽章、區塊鏈與資料識別,以下依序說明這些應用面向。
最直接的用途是檔案完整性檢查:計算檔案的雜湊值,之後再算一次,兩個結果一致,就代表內容沒有改變。軟體發布也運用同樣的做法,提供下載的一方公布檔案的雜湊值,使用者下載完成後自行計算比對,確認下載過程沒有損壞或被替換。
在數位簽章與憑證領域,SHA-256 負責先把大量資料縮成摘要,再由簽章演算法處理這段摘要,這也呼應了第二節提到的原始用途。區塊鏈同樣用雜湊串接資料,讓前一筆紀錄的內容變動時,後面的紀錄也會隨之失效。此外,雜湊值也可以用來辨識資料:內容完全相同的檔案會得到相同的摘要,因此可以用來找出重複檔案,或識別某一個版本。
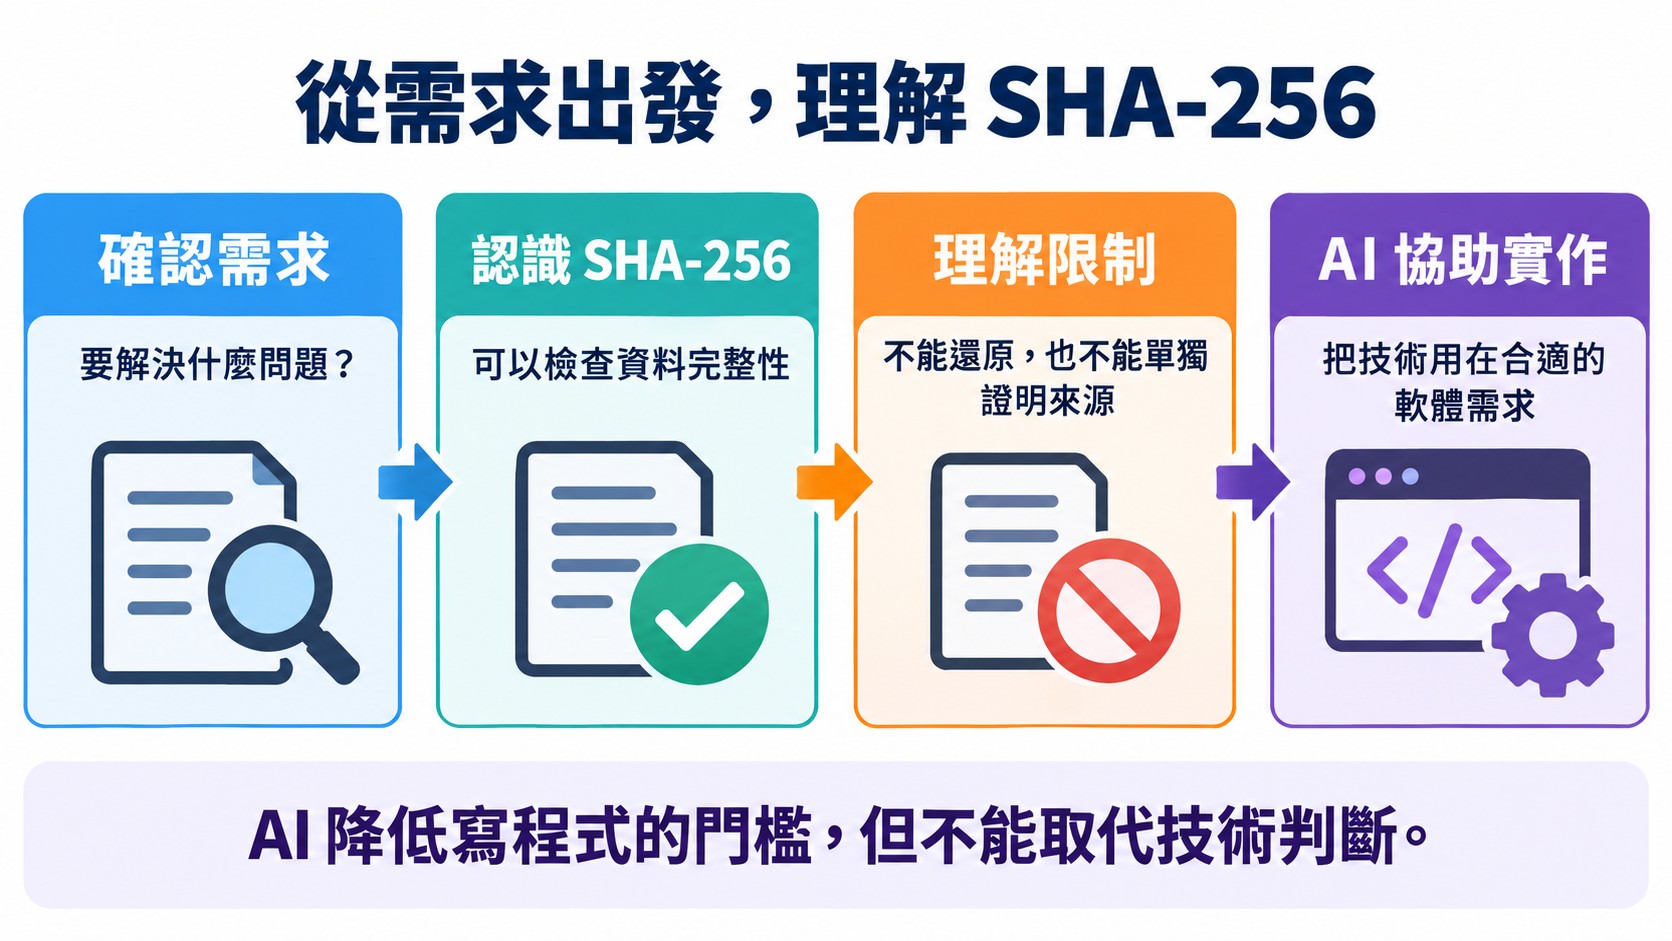
要留意的是,相同的雜湊值只能證明內容一致,並不能證明檔案來源可信。如果雜湊值與檔案是從同一個不可信的地方取得,兩者可能一起被換掉,所以仍需要確認雜湊值是來自可信的管道。
理解 SHA-256,從技術觀念開始學習 AI 程式設計
回頭看贊贊小屋最初的兩個疑問,「它是不是只抽樣一部分」和「256 位元怎麼裝得下一整份 Excel」,剛好都是要不要信任一個工具之前,該先問清楚的問題。
現在要計算 SHA-256,其實不需要自己實作補位與 64 輪運算。透過 Python 等程式語言提供的標準函式庫,或請 AI 協助撰寫程式,就能完成檔案摘要計算。
但程式能不能跑,並不是學習 AI 程式設計最困難的部分。真正需要的是知道這類程式在解決什麼問題:它檢查的是內容有沒有改變,而不是來源是否可信;它讀取的是完整檔案,不是抽樣;它產生的是摘要,不是加密,也不能還原資料。理解這些限制,才有辦法判斷什麼場合應該把雜湊檢查加入軟體開發的需求,什麼場合需要搭配其他機制。
AI 讓寫程式的門檻降低了,卻沒有讓觀念變得不重要。需求說得越準確,AI 能做的事就越接近真正需要的結果,而 SHA-256 正是一個很好的起點:小小的一串字元,背後是資料完整性、數學限制與信任範圍的取捨。