軟體開發流程是什麼?MVP 能跑起來,不代表軟體開發已結束,還要經過設計、開發、測試、部署與維護,才成為可長期使用的產品,這套順序就是軟體開發生命週期(SDLC)。本文以 Figma 主線搭配 GitHub、Netflix、Etsy 案例,說明各階段在做什麼與 AI 時代為何仍不能跳過。
一、軟體開發流程是什麼?從 MVP 到真正可以使用的軟體
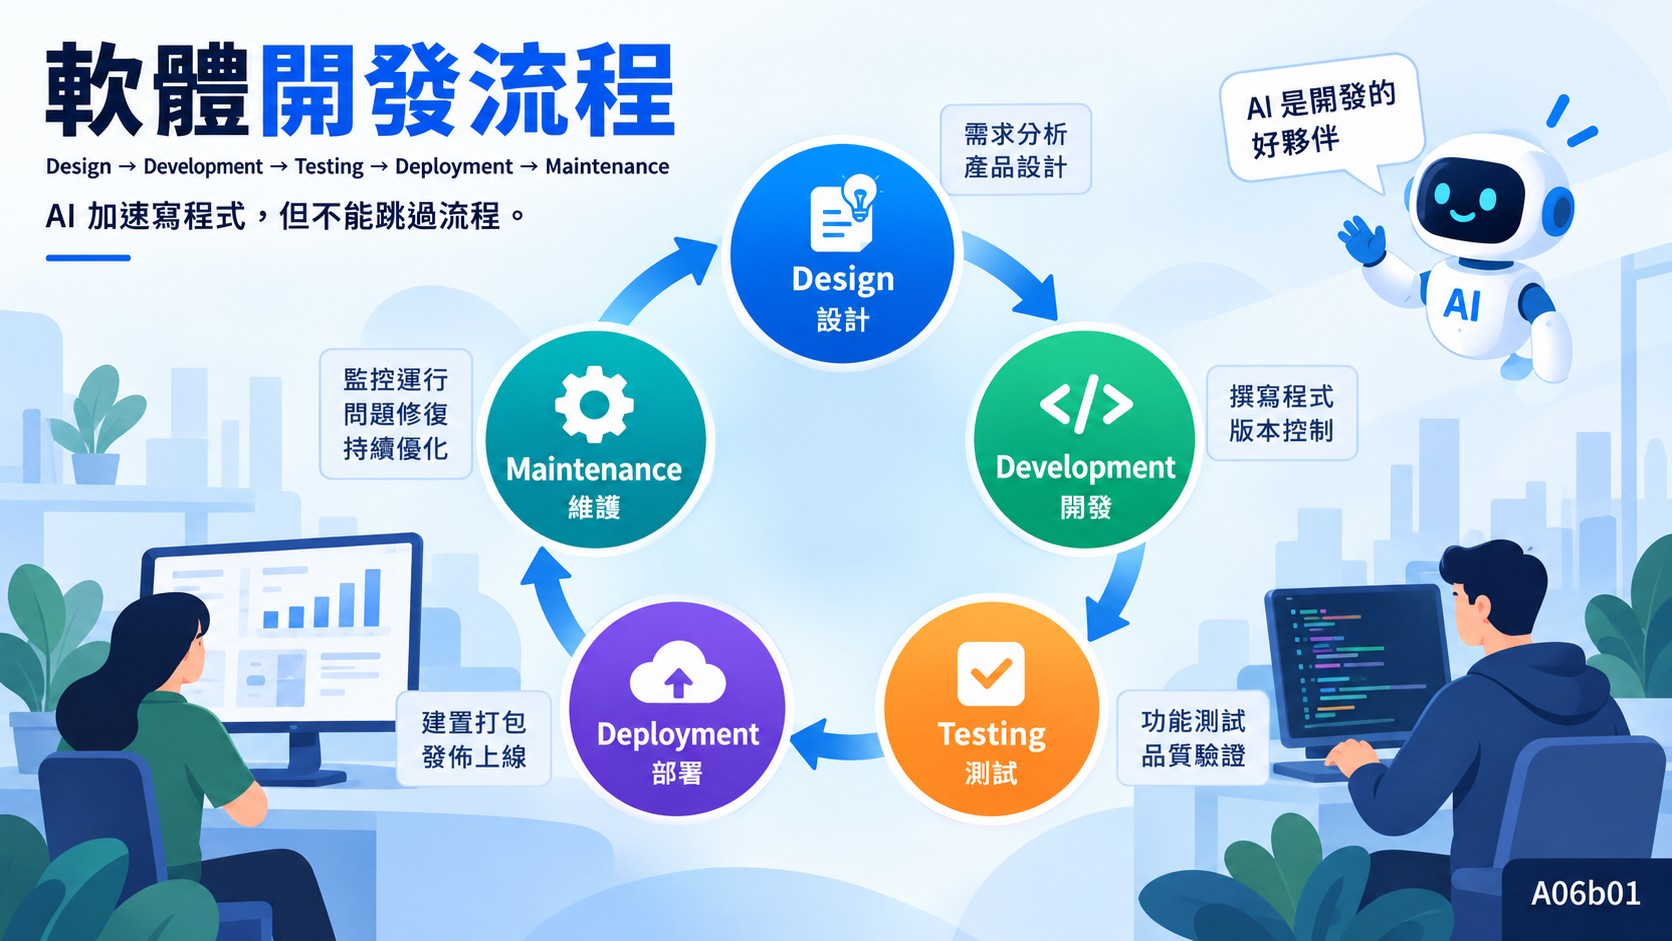
很多人以為軟體開發做到 MVP(最小可行產品)就算完成,先把核心功能做出來、交給使用者試用,接下來只是「慢慢加功能」而已。但實際情況是,MVP 只是驗證了「這個方向值得做」,離「這是一套可以長期穩定運作的軟體」還有很長一段距離。真正把一個構想變成可以持續使用的產品,中間還需要經過設計、開發、測試、部署與維護這幾個步驟,這整套流程在軟體工程裡稱為 Software Development Life Cycle(SDLC),中文常譯為軟體開發生命週期,也就是軟體開發流程實際展開後的樣子。
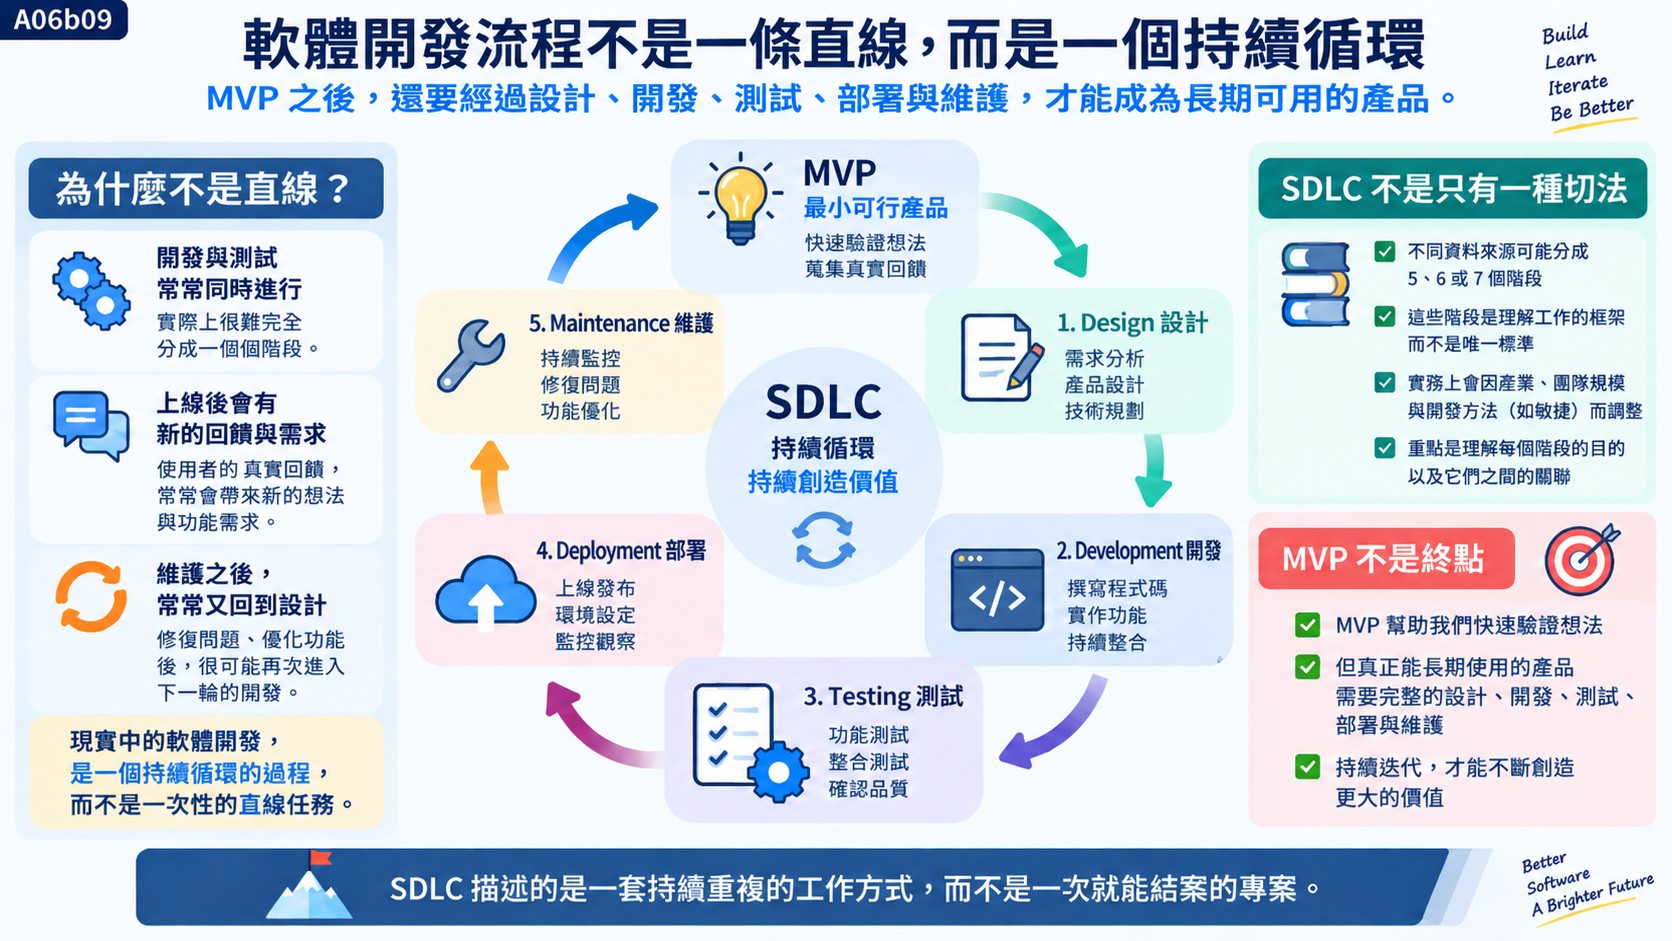
不同資料來源拆解 SDLC 的方式並不完全一致,有的分成五個階段,有的拆成六個或七個,差異多半來自把需求分析獨立出來,或是把測試與部署再細分成更小的步驟。這篇文章不打算爭論哪一種切法才是「正確答案」,而是採用一套最適合承接前一篇文章的框架:設計(Design)、開發(Development)、測試(Testing)、部署(Deployment)、維護(Maintenance)。前一篇〈軟體開發是什麼?從問題、需求到 MVP 看懂一個產品如何誕生〉已經處理過問題、需求、範圍與 MVP 驗證,這裡不再重複解釋,直接從需求確認之後接續下去。
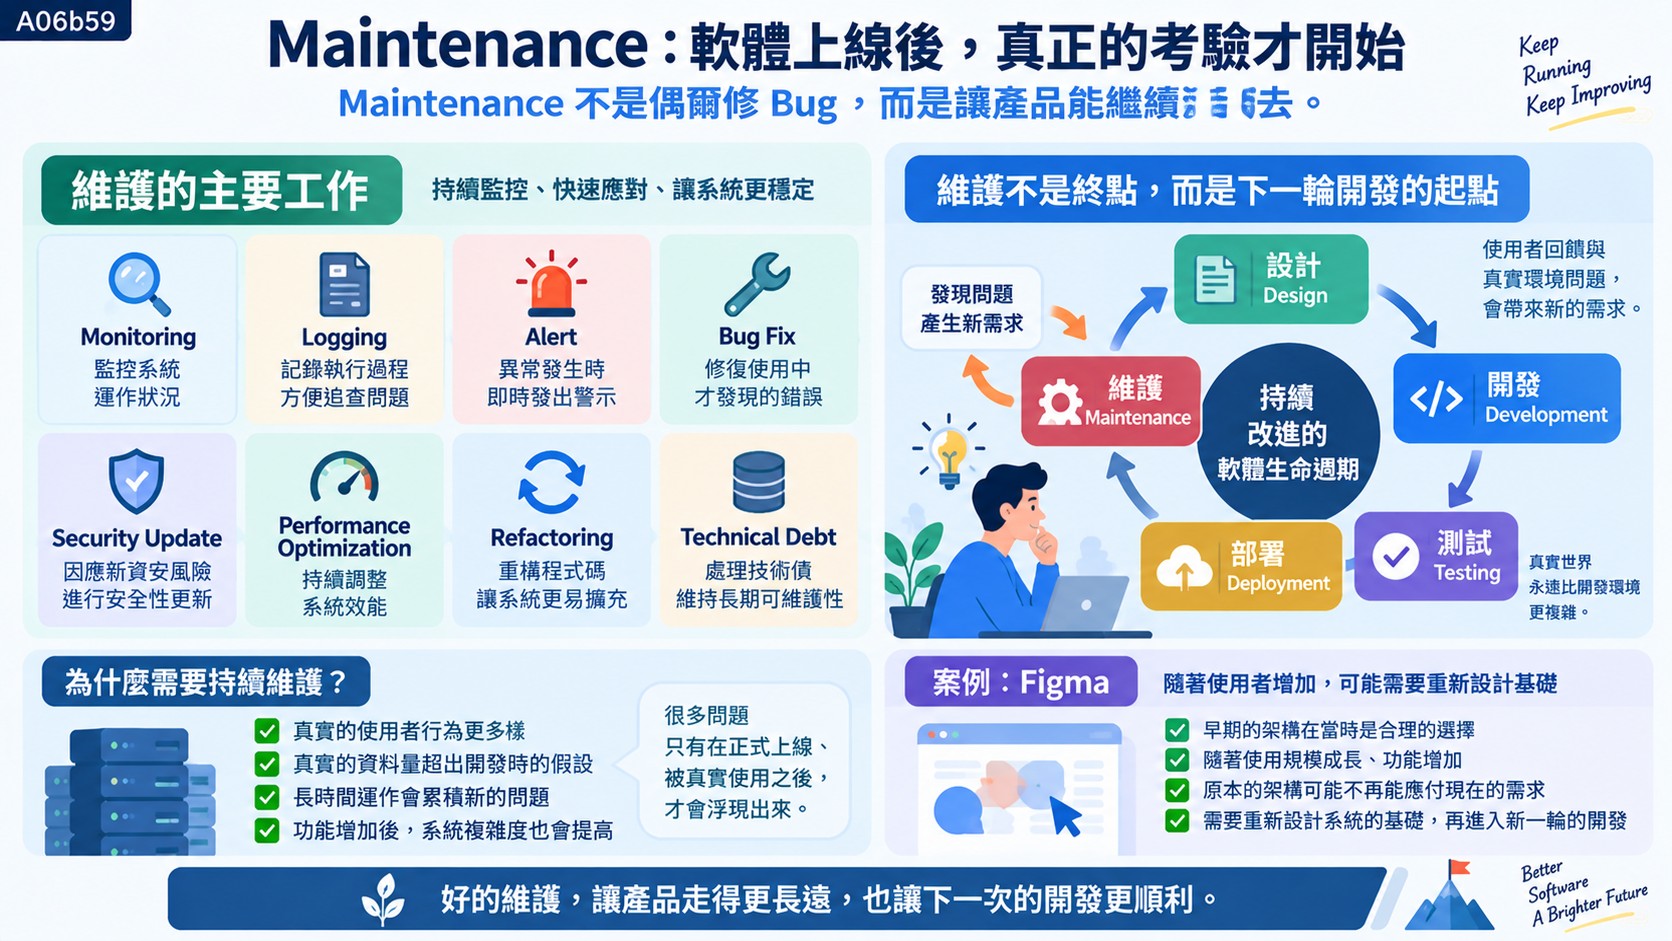
這裡有一個容易被誤解的地方:上面畫出來的流程看起來像一條直線,但實際的軟體開發很少真的照著直線走完。開發與測試經常同時進行,一邊寫新功能,一邊跑既有的測試確認沒有弄壞舊功能;軟體上線進入維護階段之後,監控與使用者回饋又會冒出新的需求,讓專案重新回到設計與開發。正因為如此,SDLC 常被畫成一個循環而不是一條終點明確的直線——它描述的是一套持續重複的工作方式,而不是一次性就能結案的專案。
二、Design:需求確定後,為什麼不能直接開始寫程式?
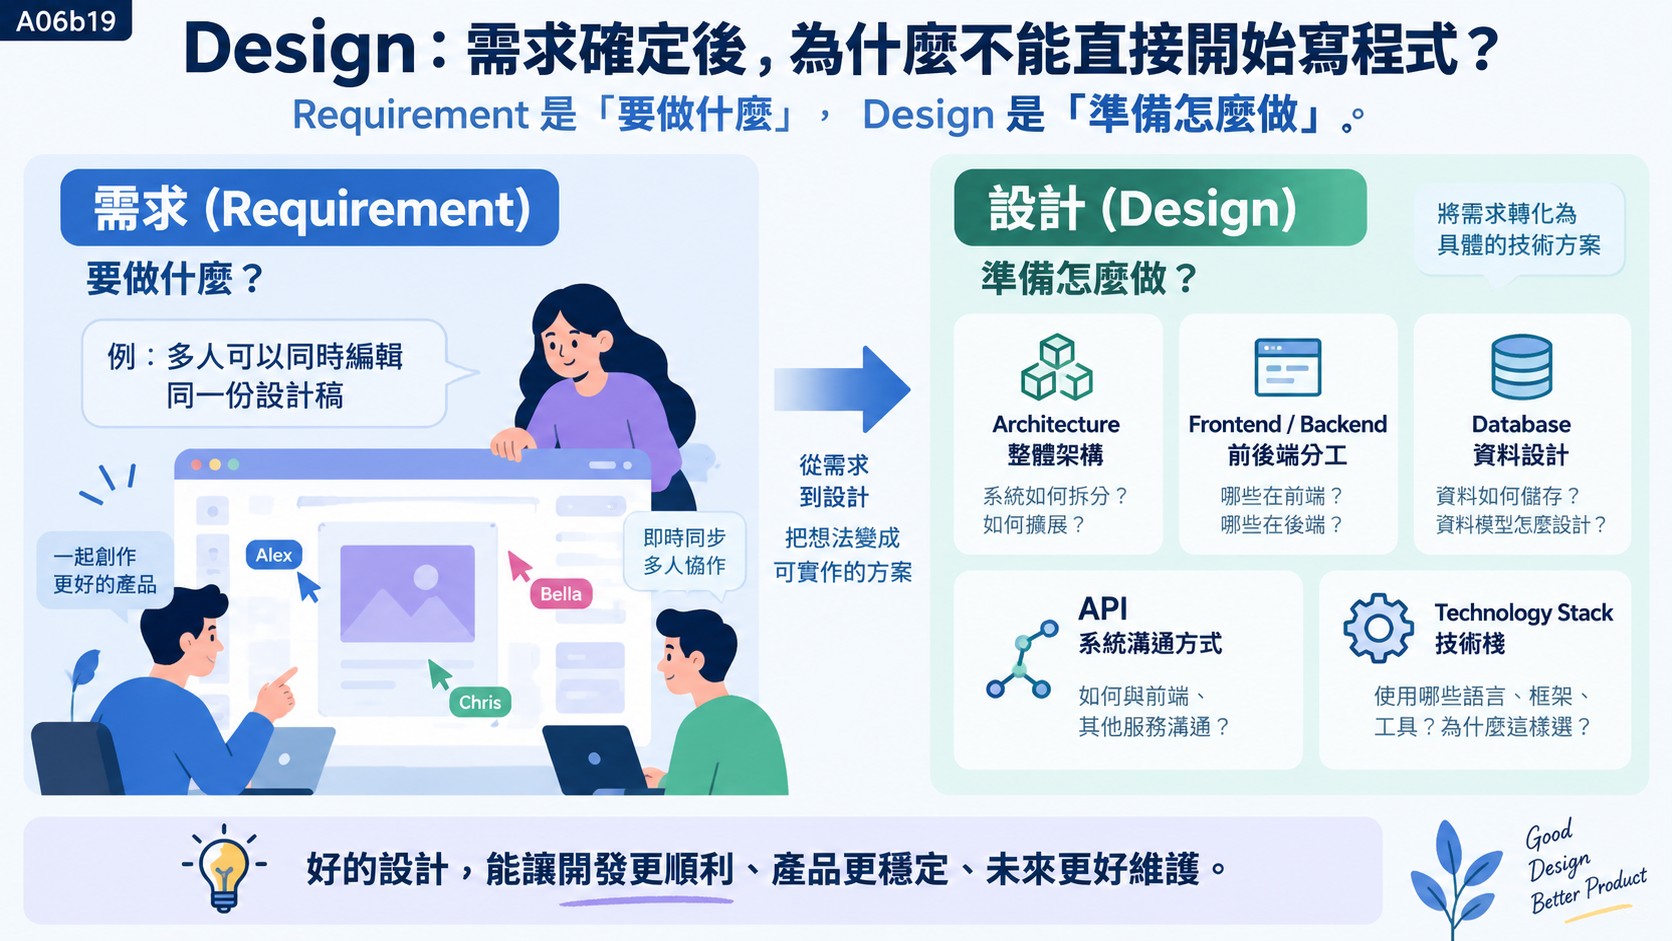
需求(Requirement)回答的是「要做什麼」,例如「使用者需要能夠同時編輯同一份設計稿」;而設計(Design)要回答的是「準備怎麼做到」。這兩者之間看似只差一步,但其實是完全不同層次的工作——同一個需求,往往可以有好幾種截然不同的技術做法,選擇哪一種,正是 Design 階段要處理的問題。
軟體設計並不等於畫幾張使用者介面稿。它通常包含整體架構(Architecture)要怎麼分工,也就是前端(Frontend)與後端(Backend)各自負責什麼;資料要如何組織與儲存,牽涉到資料庫與資料模型(Data Model)的設計;不同系統或元件之間如何溝通,會用到 API 的規劃;還要決定整套系統要建立在哪些程式語言、框架與服務之上,也就是技術棧(Technology Stack)的選擇。使用者介面與使用者體驗(UI/UX)當然也是設計的一部分,但只是其中一塊,而不是全部。
Figma 的多人協作功能很適合說明這個層次的差異。「多個人可以同時在同一份設計稿上編輯」這句話本身只是一項需求,說明了使用者想要什麼,但完全沒有說明要怎麼實現。真正進入設計階段後,團隊必須回答一連串更具體的問題:當兩個人同時修改同一個圖層,資料要怎麼即時同步而不互相覆蓋?哪些運算應該放在使用者自己的瀏覽器裡完成,哪些又必須交給伺服器統一處理?如果兩個人的修改幾乎在同一瞬間發生,系統要用什麼機制判斷、合併,才不會讓其中一方的變更憑空消失?這些問題沒有單一標準答案,同一個「多人協作」的需求,理論上可以透過好幾種不同的技術路徑實現,而設計階段的任務,正是在真正動手寫程式之前,先想清楚要走哪一條路,並確認這條路在技術上站得住腳。
方案一旦確定,接下來要做的,就是把這個設計方案拆解成一個個可以實際動手實作的工作項目,這也是下一階段開發(Development)要處理的事。
三、Development:寫程式只是軟體開發其中一段
很多人對軟體開發的想像,就是「工程師坐下來一直寫程式」,但這其實只描述了開發階段裡最表層的動作。真正重要的工作,是把設計階段已經確認的方案,拆解成一個個可以被實作、檢查、整合進整套系統的變更,而不是一次把所有程式碼寫完再整包丟出來。
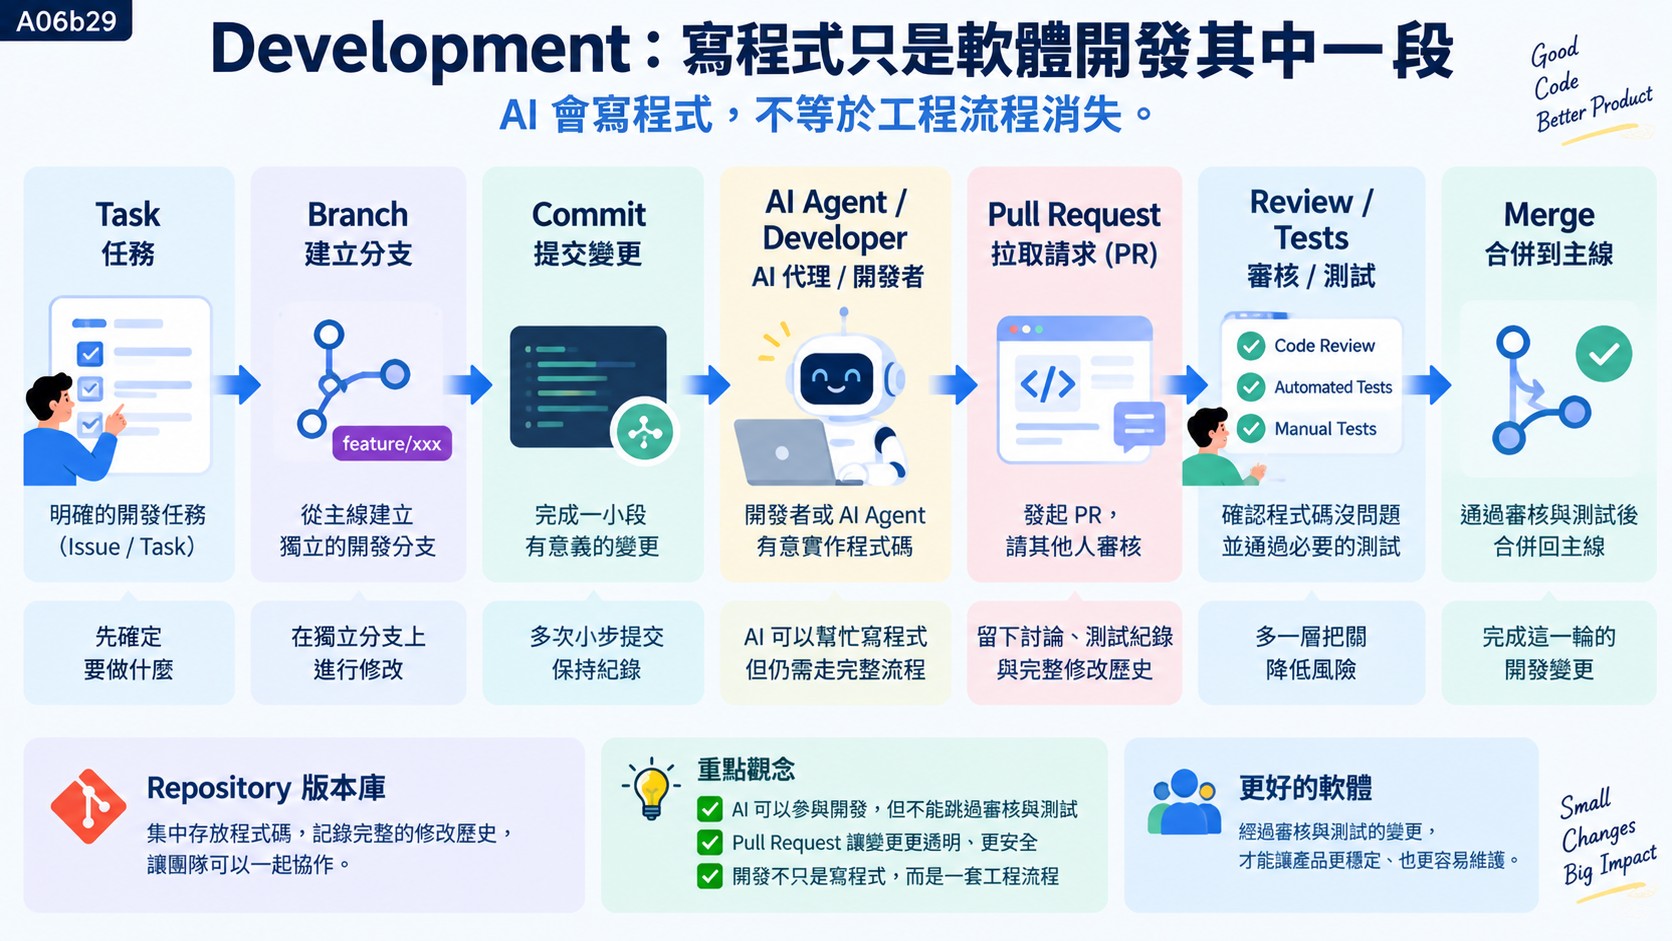
多數團隊會透過版本控制(Version Control,最常見的工具是 Git)來管理這些變更。程式碼集中存放在一個版本庫(Repository)裡,開發者要修改功能時,通常會先從主線拉出一個獨立的分支(Branch),在這個分支上進行修改,每完成一小段有意義的變更,就記錄成一次提交(Commit)。變更完成後,開發者會發起一個拉取請求(Pull Request,簡稱 PR),請其他人審核這批變更,確認沒有問題、也通過必要的測試之後,才會正式合併(Merge)回主線。GitHub 之所以成為許多團隊使用的平台,關鍵不只是它能存放程式碼,而是 Pull Request 這套機制的價值:它讓一批變更在真正進入主線之前,留下討論、審核、測試紀錄與完整的修改歷史,任何人事後都能回頭查看某段程式碼為什麼被這樣修改。
AI Coding Agent 的出現,讓這套流程有了新的角色加入,但沒有改變流程本身的邏輯。一個常見的工作方式是:先有一項具體任務(Issue/Task),交給 AI Coding Agent 去實作,AI 完成修改後同樣發起 Pull Request,接受審核與測試,通過之後才合併進主線。這裡真正值得留意的,不是「AI 有沒有能力直接修改程式碼」——這件事本身已經不太有疑問——而是「有能力修改,不代表修改應該跳過既有的工程驗證流程」。AI 可以大幅縮短從任務到程式碼的時間,但變更是否正確、是否會影響其他功能,仍然需要透過審核與測試來確認,這套把關機制並不會因為換成 AI 動手寫程式,就變得可有可無。
四、Testing:測試不是最後找 Bug,而是確認軟體真的符合要求
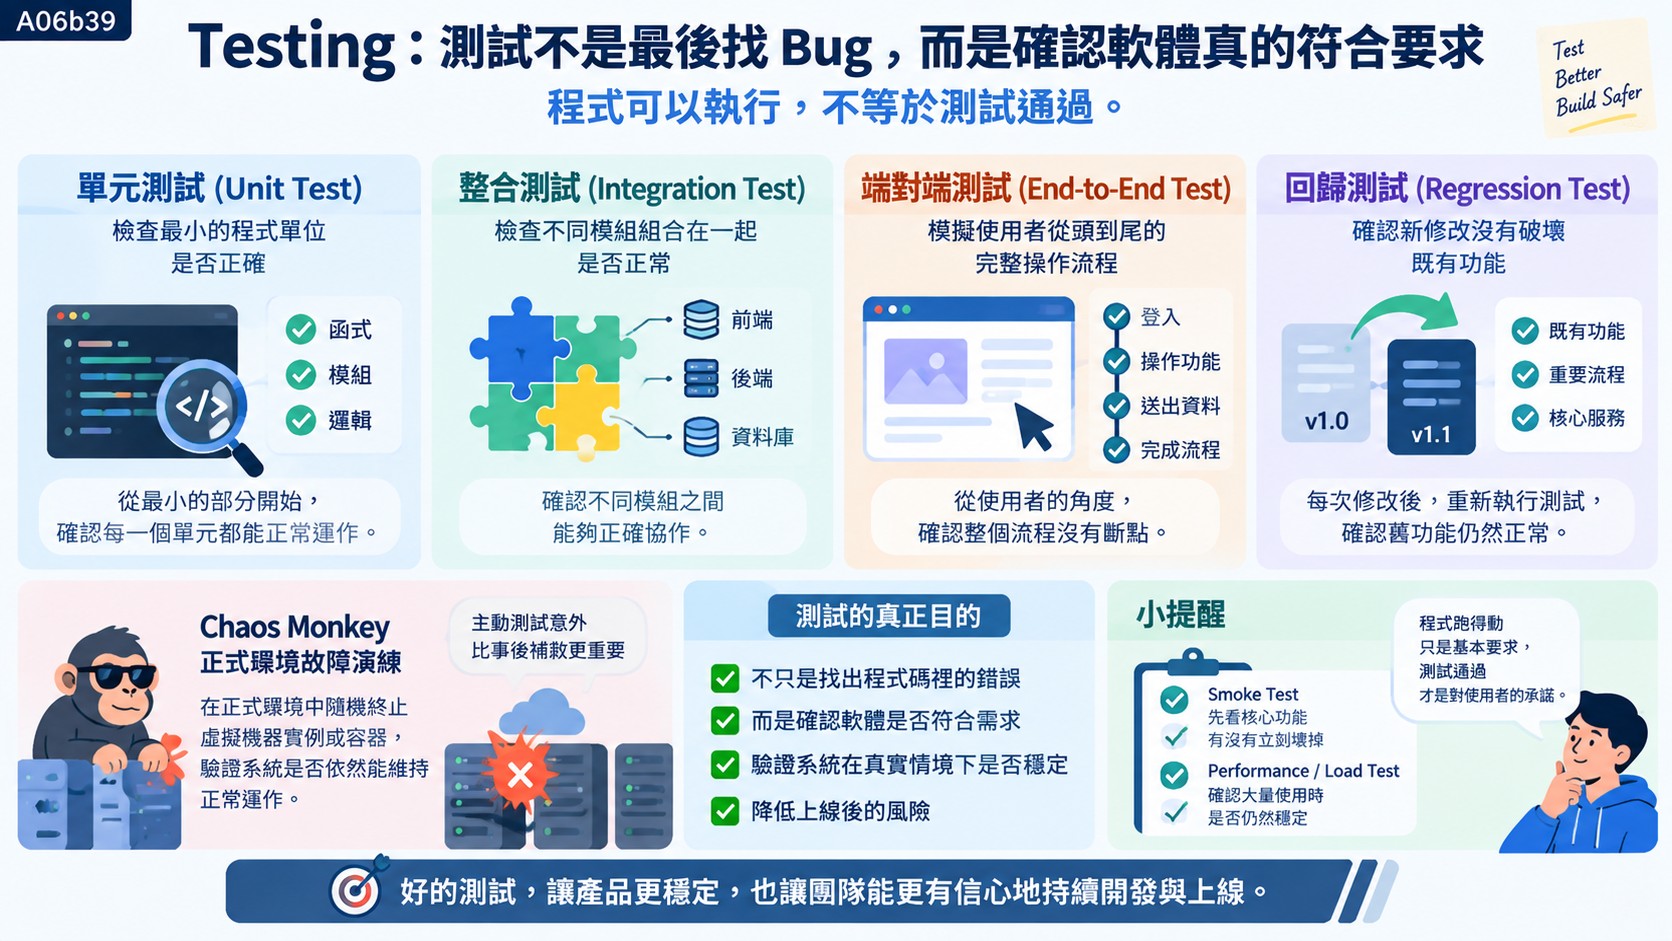
「程式可以執行」和「測試通過」是兩件不一樣的事,這是理解 Testing 階段最重要的第一步。一段程式碼即使順利跑完、沒有跳出錯誤訊息,也不代表它做的事情是對的,更不代表它符合原本的需求。完整的測試工作,至少要同時回答幾個層次的問題:每一個程式單元本身有沒有邏輯錯誤?不同模組串接在一起之後,介面銜接有沒有問題?從使用者的角度,一個完整的操作流程能不能順利走完?這次新增的修改,有沒有不小心弄壞原本運作正常的功能?以及最根本的,整體結果究竟有沒有真的符合當初設定的需求?
對應這幾個層次,軟體工程上發展出幾種不同範圍的測試方式。單元測試(Unit Test)針對最小的程式單位,確認一個函式或一個模組本身的邏輯是否正確;整合測試(Integration Test)確認不同模組組合在一起之後能否正常協作;端對端測試(End-to-End Test)則模擬使用者從頭到尾的完整操作路徑,確認整個流程沒有斷點。而每次修改程式之後,重新執行既有的測試、確認舊功能沒有被新變更破壞,稱為回歸測試(Regression Test),這在持續修改、持續上線的開發節奏裡尤其重要。除此之外,效能測試或負載測試(Performance/Load Test)用來確認系統在大量使用者同時操作時是否仍然穩定,也是完整測試工作的一部分,只是不是每個專案在每個階段都需要投入同樣的力氣。
Netflix 的 Chaos Monkey 提供了一個把測試觀念再往前推一步的例子。這套工具會在正式環境中隨機終止虛擬機器實例或容器,藉此確認當基礎設施真的發生故障時,整套服務是否依然能維持正常運作,而不是等到真正出事故才第一次面對這種情況。這個做法說明了一件事:成熟的測試思維,不只是在事前找出程式碼裡的錯誤,更包含主動驗證系統面對真實世界的故障與意外時,是否仍然能夠符合原本的預期表現。放回日常開發的尺度來看,開發者也會用比較輕量的方式體現類似的謹慎——例如先做一次冒煙測試(Smoke Test),快速確認核心功能沒有立即壞掉,再搭配前面提到的回歸測試,確認這一輪修改沒有波及其他既有功能。
五、Deployment:程式寫完,為什麼還不能直接交給使用者?
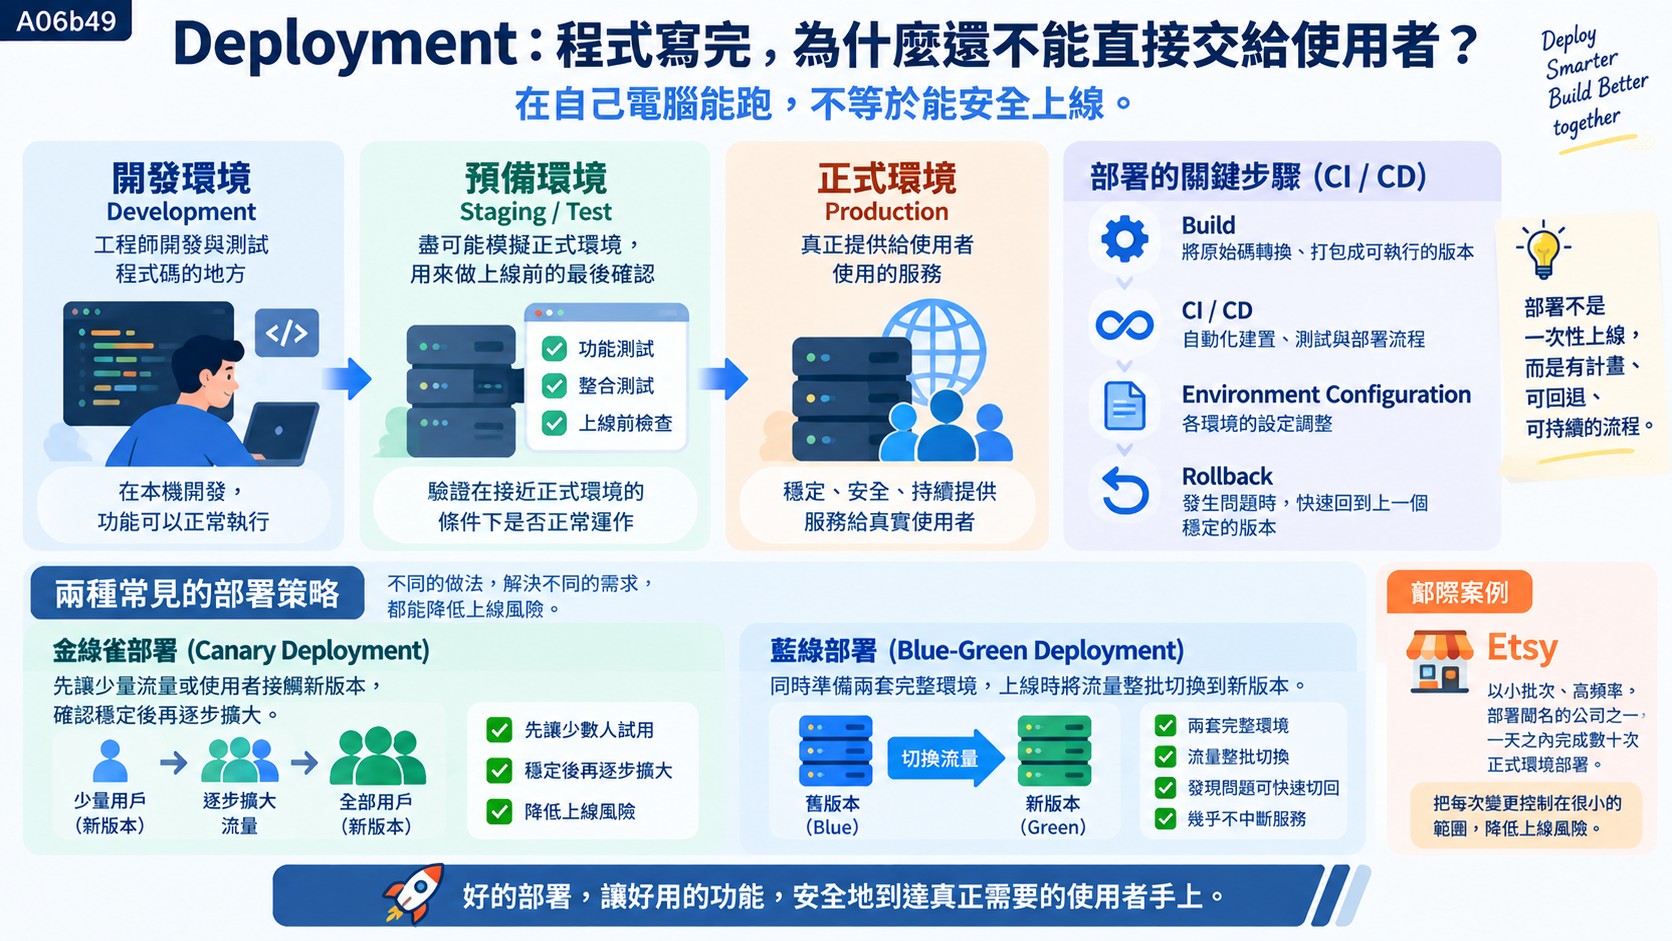
程式在自己的電腦上可以正常執行,和它可以安全地提供給真正的使用者使用,是兩件不同的事。多數團隊會建立至少三層環境來處理這個落差:開發環境(Development)是工程師平常撰寫與測試程式碼的地方;預備環境(Staging,有時也稱為測試環境)盡可能模擬正式環境的設定,用來做上線前的最後確認;正式環境(Production)才是真正使用者會接觸到的服務。程式碼要從開發環境走到正式環境,中間通常會先經過建置(Build),把原始碼轉換、打包成可以實際執行的版本,再透過持續整合與持續交付或部署(CI/CD,Continuous Integration/Continuous Delivery 或 Deployment)的自動化流程,把這個版本依序送往預備環境、再送往正式環境,過程中也包含各環境所需的設定(Environment Configuration)調整。
部署不是「準備好就一次性全部上線」的動作,許多採持續交付/部署的團隊,會把一次大規模的變更拆成很多次較小的部署,而不是長時間累積出一個龐大的版本後才一次性推出。金絲雀部署(Canary Deployment)是實現漸進釋出很典型的做法:先讓一小部分流量或使用者接觸到新版本,確認穩定後再逐步擴大範圍。藍綠部署(Blue-Green Deployment)處理的則是另一個問題——它會同時準備兩套完整環境,上線時把流量整批切換到新版本,重點不在於逐步曝光,而在於切換幾乎不中斷服務,一旦發現問題也能立刻把流量切回舊環境。兩種做法都能降低上線風險,只是分別針對「先讓少數人試用」與「切換要快、要能立刻退回」這兩種不同的需求。Etsy 就是以小批次、高頻率部署聞名的公司之一,一天之內完成數十次正式環境部署,靠的正是把每次變更控制在很小的範圍,而不是每隔很長一段時間才進行一次大改版。
即使做了這麼多準備,新版本上線後仍然可能出現預期之外的問題,這時候回滾(Rollback)機制就派上用場——把系統快速還原到上一個已知穩定的版本。值得留意的是,Rollback 應該是部署設計裡原本就存在的一環,而不是等到真的出事故才臨時想辦法補救;一套成熟的部署流程,會在設計階段就把「萬一新版本有問題,要怎麼安全退回」考慮進去,而不是把它當成意外狀況才需要面對的緊急應變。
六、Maintenance:軟體上線後,真正的考驗才開始
軟體上線,並不代表開發工作已經結束,維護(Maintenance)常被誤解成「偶爾修一下 Bug」,但實際涵蓋的範圍遠不止於此。上線之後的維護工作,包含持續監控系統運作狀況(Monitoring)、記錄系統執行過程中的重要資訊以便日後追查問題(Logging)、在異常發生時即時發出警示(Alert)、修復使用中才被發現的錯誤(Bug Fix)、因應新出現的資安風險進行安全性更新(Security Update)、持續調整系統效能(Performance Optimization),以及處理隨著功能增加而逐漸累積的技術債(Technical Debt),透過重構(Refactoring)讓程式碼維持在可以繼續擴充的狀態。
會需要這麼多維護工作,根本原因在於開發環境永遠無法完全模擬正式環境會遇到的一切。真實的使用者行為往往比想像中更多樣,真實的資料量與資料型態經常超出開發時的假設,真實的流量模式、長時間持續運作累積出來的狀態,也很難在開發階段被完整重現。正因為如此,很多問題只有在軟體正式上線、被真實使用之後,才會第一次真正浮現出來。
Figma 早期的架構,是為了讓多人可以同時即時協作編輯而設計,在當時的技術條件與使用規模下,這套架構是合理、也確實有效的選擇。但隨著使用者數量持續成長、功能不斷增加、系統本身的複雜度也隨之累積,多年之後,原本合理的架構基礎,可能就不再能夠從容應付現在的規模與需求,這時候就需要重新設計系統的基礎(Foundation)。而這個「重新設計」的動作,其實就是重新回到設計、開發、測試、逐步部署,再進入監控的完整循環。從這個角度來看,維護並不是軟體生命週期的終點,反而經常是下一輪軟體開發真正的起點。
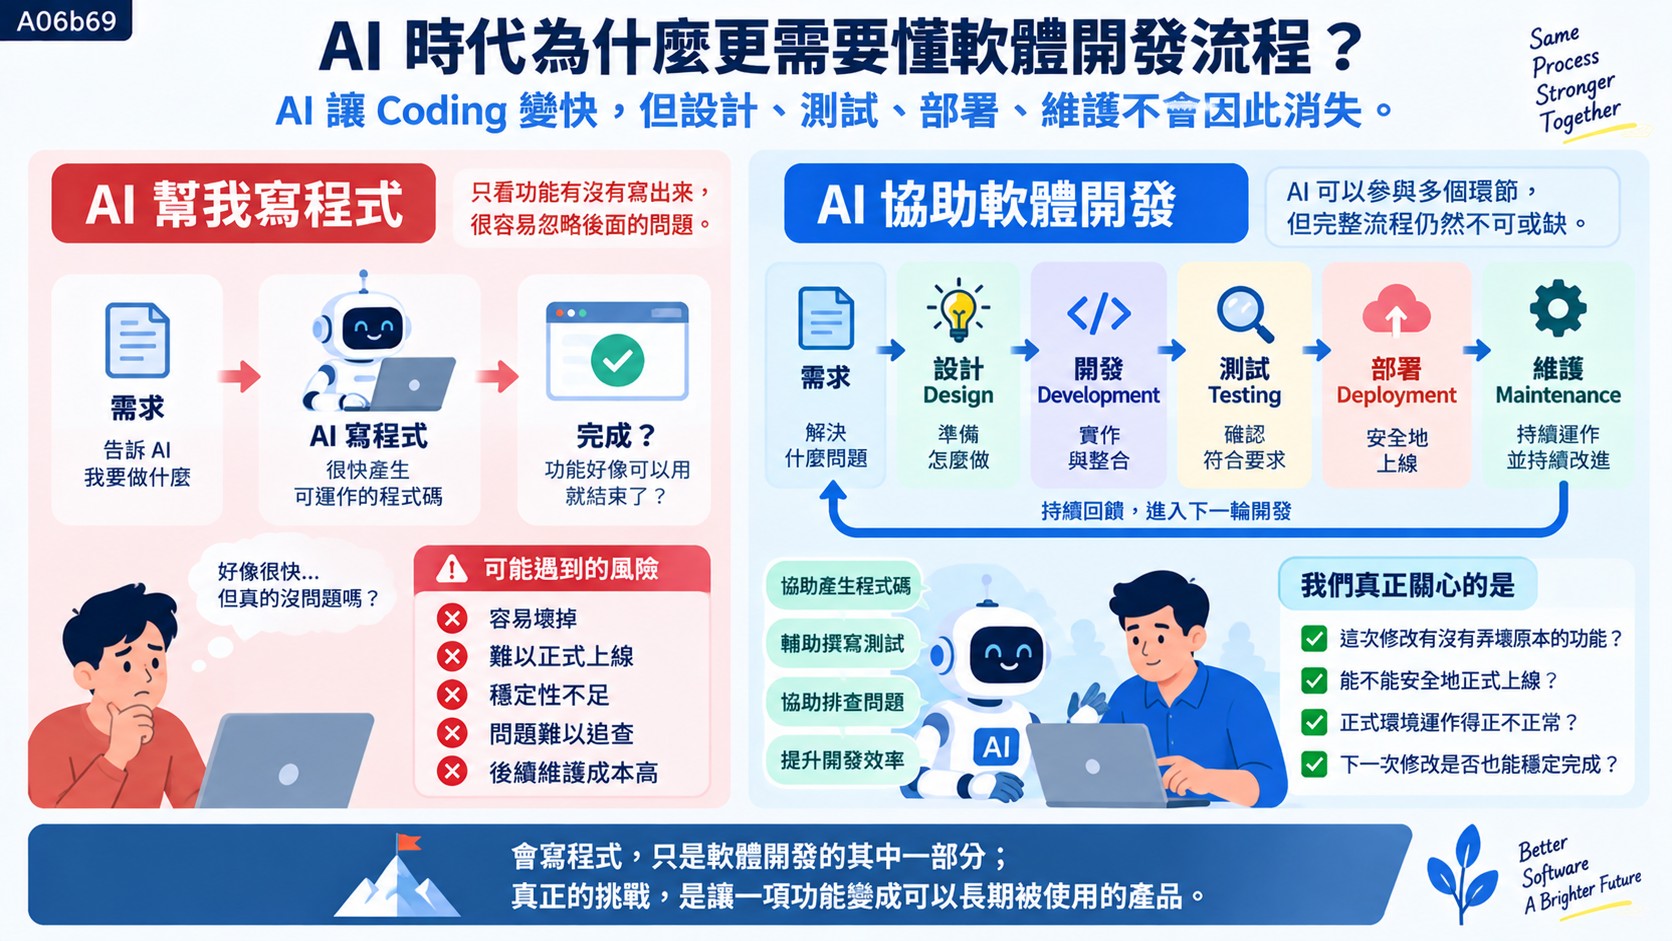
AI 時代為什麼更需要懂軟體開發流程?
過去,多數人會直覺地認為軟體開發裡最困難的部分是寫程式(Coding)本身。AI 的出現,讓寫程式的成本快速下降,只要把需求說清楚,AI 就能在很短的時間內產生一大段可以運作的程式碼,這很容易讓人產生一種錯覺:只要把需求告訴 AI,等它把程式寫完,軟體開發就算完成了。
但回頭看完整的流程就會發現,這中間漏掉了太多環節。從知道要做什麼開始,中間還要經過設計、開發、測試、部署、維護,再回到下一輪的設計與開發,這是一套持續運轉的循環,而不是「需求說清楚、程式寫出來」就能一次結案的單一動作。AI 確實可以參與、甚至高度自動化其中的多個階段,從產生程式碼、輔助撰寫測試,到協助排查部署過程中的問題,能發揮的範圍愈來愈廣。但 AI 加速了其中某一個階段,並不代表那個階段前後原本就存在的工程問題會因此自動消失——設計方案是否合理、測試是否真的驗證了正確的東西、部署是否安全可回退、上線後要如何維護,這些判斷仍然需要人親自參與。
實際使用 AI Agent 參與愈來愈多程式專案之後,會發現自己在意的問題其實在慢慢轉移。剛開始接觸 AI 寫程式的時候,最容易關心的問題是「AI 能不能把這個功能寫出來」;但隨著經手的專案愈來愈多,真正開始在意的問題,會逐漸變成「這次修改之後,有沒有把原本正常的功能弄壞」「這個版本能不能安全地正式上線」「正式環境現在運作得正不正常」「下一次修改,還能不能像這次一樣穩定地完成」。這正是「AI 幫我寫程式」和「AI 協助軟體開發」之間真正的差別——前者只看單一段程式碼有沒有被寫出來,後者則把設計、測試、部署、維護這些前後工作都一併放進判斷裡。會寫程式,只是軟體開發的其中一部分;真正開始理解設計、測試、部署和維護,才會開始看見一套軟體如何從一項功能,變成可以長期被使用的產品。