交通部觀光署的遊客人數 Excel 報表資料完整、分類清楚,為什麼還需要資料正規化?正規化的意思,是依資料之間的相依關係重新安排資料表與欄位,減少重複並讓資料更一致。贊贊小屋用 ChatGPT 免費版分析這份官方報表,從 AI 提出的兩張資料表方案,理解正規化的目的與 3 個基本步驟。
一、政府公開資料:交通部觀光署遊客人數統計
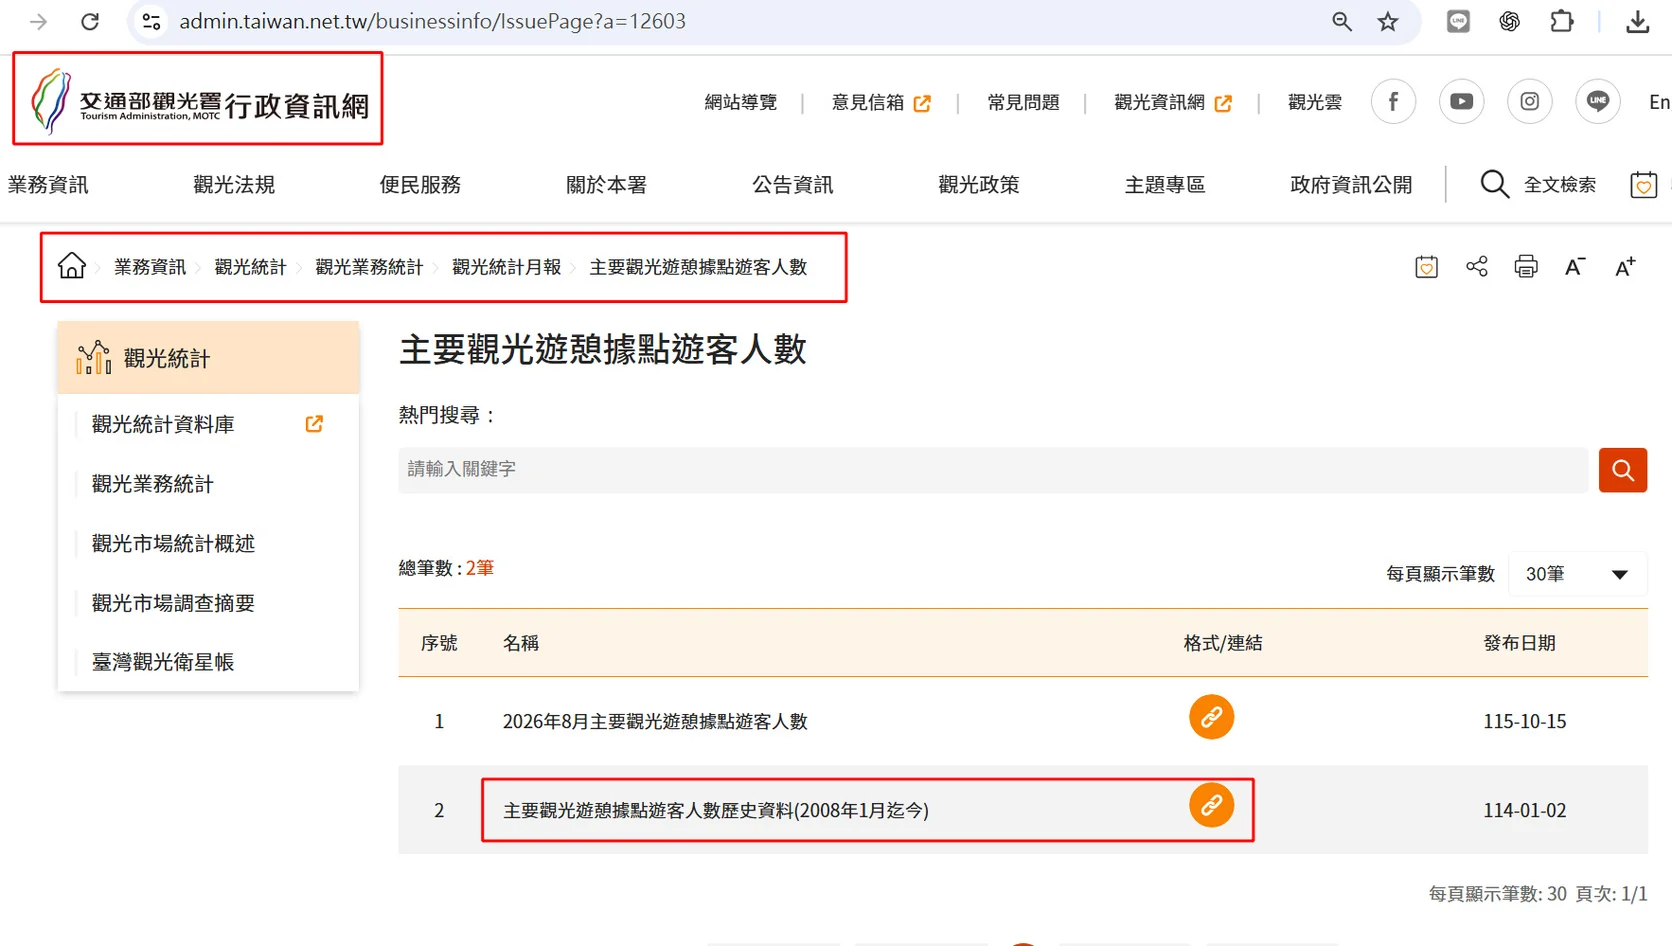
這次的資料來自交通部觀光署行政資訊網。贊贊小屋找到的「主要觀光遊憩據點遊客人數」頁面,上方的導覽路徑依序是「業務資訊」「觀光統計」「觀光業務統計」「觀光統計月報」,可以看出它屬於觀光統計月報底下的一項統計。頁面列表目前有兩筆資料:第一筆是「2026年8月主要觀光遊憩據點遊客人數」,發布日期為 115-10-15;第二筆是「主要觀光遊憩據點遊客人數歷史資料(2008年1月迄今)」,發布日期為 114-01-02。左側的觀光統計選單另外提供「觀光統計資料庫」的入口,可以依年度與月份查詢統計報表。
政府機關定期公布的統計資料,原本是讓民眾、研究者與企業了解觀光現況,但它同樣是很好的資料分析素材。官方報表有明確的發布機關、統計方法與資料說明,數字來源可以追溯,用它來練習 Excel 或 AI 資料分析,比自己編造的範例更貼近實際工作。辦公室裡常見的情況也是如此:手上的資料往往是別人已經整理好的正式報表,而不是為了分析而設計的原始資料。
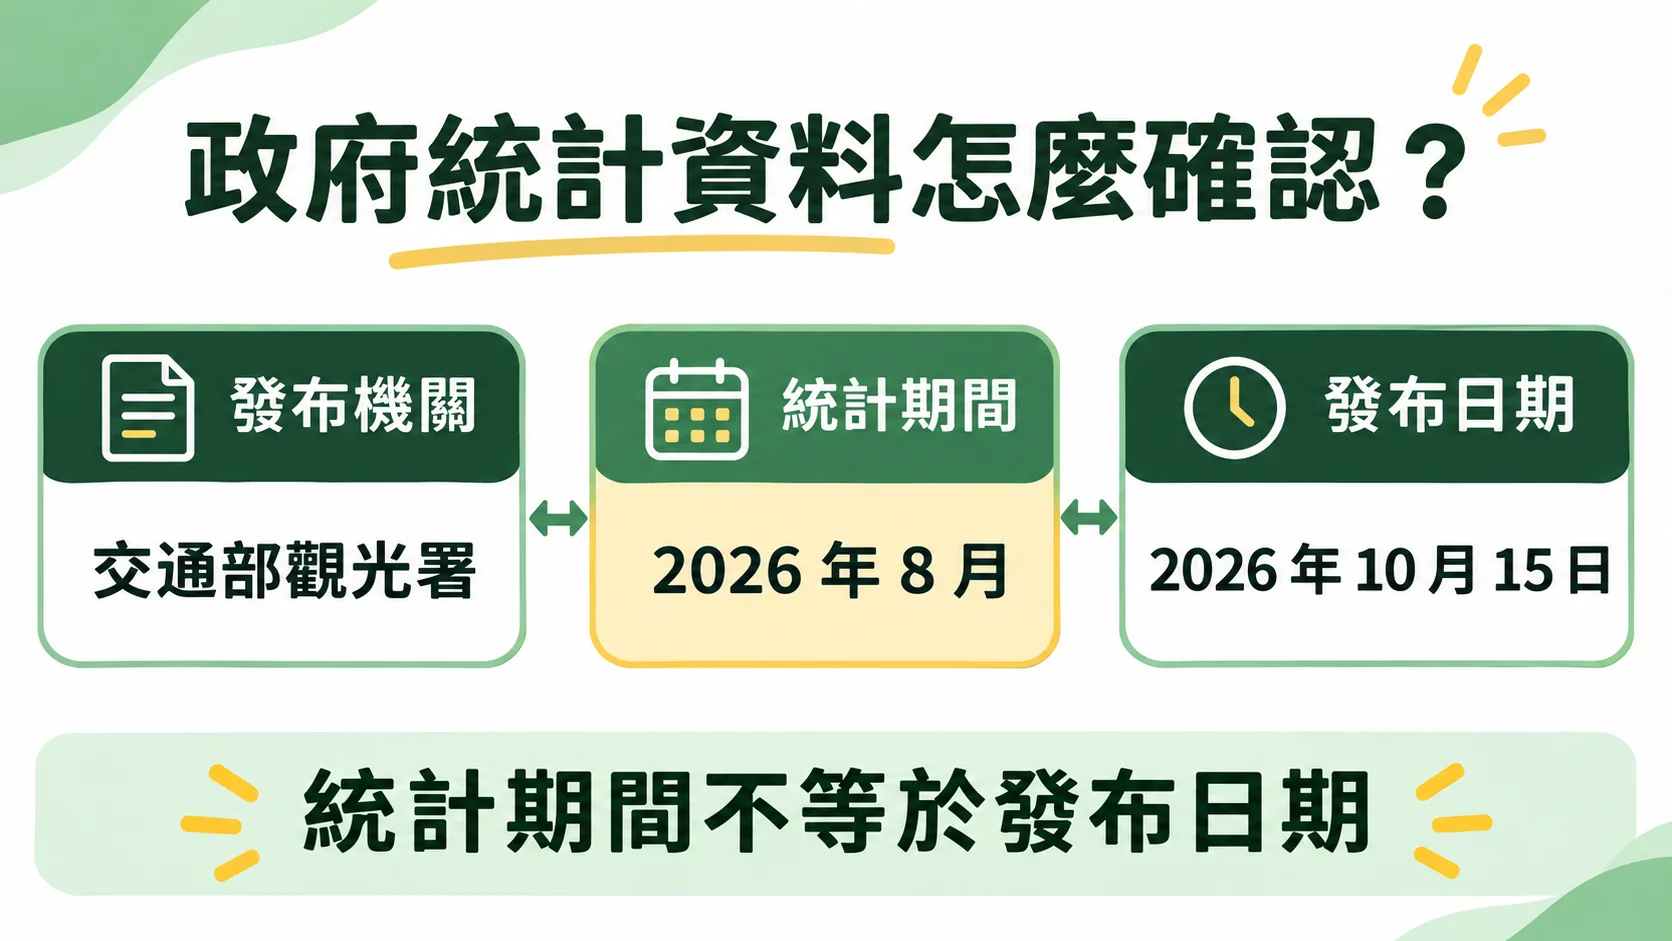
使用官方資料時,有三個資訊值得一起記下來:發布機關、統計期間與發布日期。統計期間和發布日期並不相同,以列表中的第一筆為例,統計期間是 2026 年 8 月,發布日期則是 115 年 10 月 15 日,兩者相差約兩個月,可見統計資料是在統計期間結束一段時間後才公布。之後引用數字時,應該寫清楚是哪一段期間的統計,而不是用下載或發布的日期代替。AI 資料分析也應該從這裡開始:先保留原始檔案與官方出處,後續無論怎麼整理、轉換或分析,都能回頭核對原始數字。
二、Excel 統計報表:下載 XLSX 與 ODS 檔案
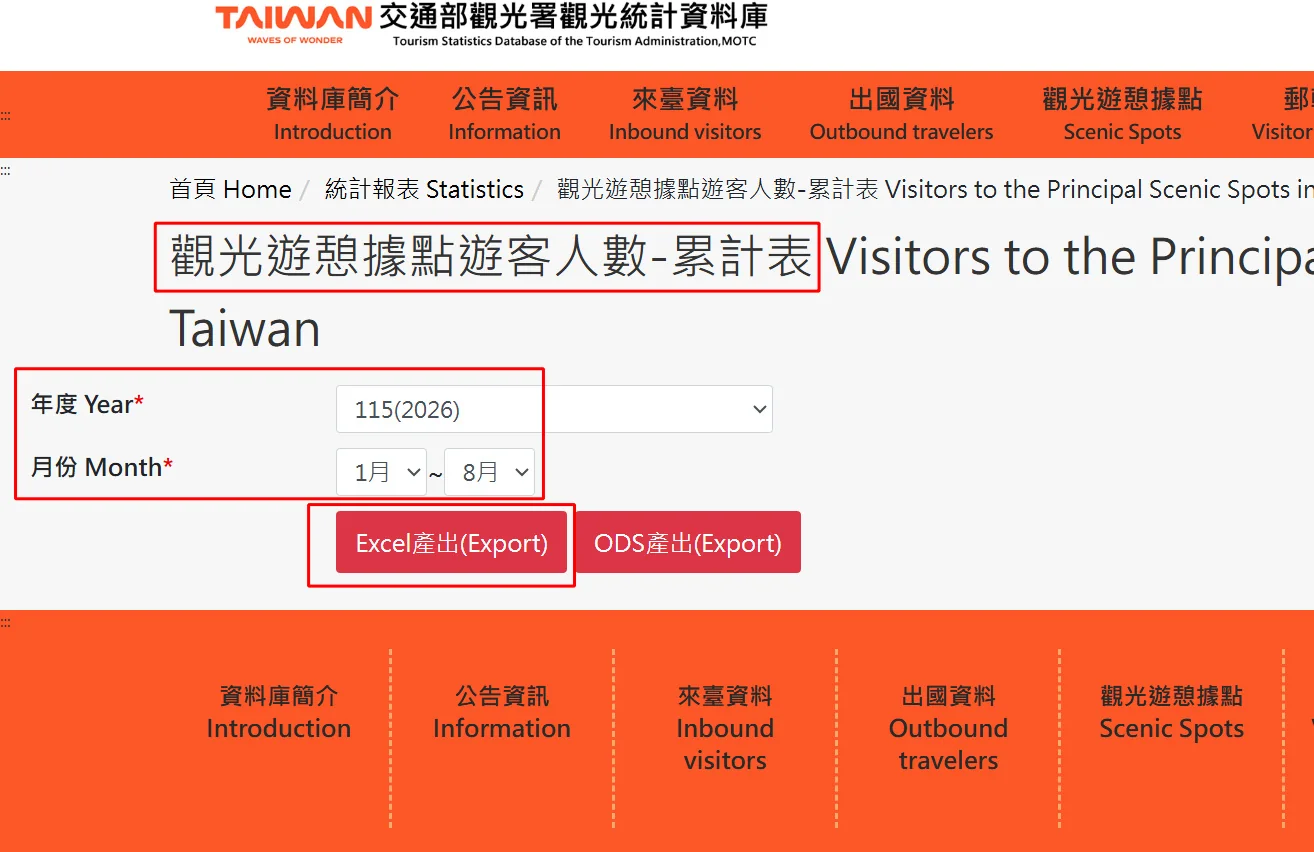
進入交通部觀光署觀光統計資料庫的「觀光遊憩據點遊客人數-累計表」頁面後,畫面上有兩個必填條件:「年度 Year」與「月份 Month」。贊贊小屋在年度選擇「115(2026)」,月份從「1月」選到「8月」,也就是查詢 2026 年 1 月至 8 月的累計資料。條件下方有兩個按鈕,分別是「Excel產出(Export)」與「ODS產出(Export)」;這次按下「Excel產出(Export)」,下載的是一個 XLSX 格式的 Excel 檔案。
另一個「ODS產出(Export)」按鈕下載的是 ODS 檔案。ODS 是 OpenDocument Spreadsheet 的縮寫,中文可以稱為開放文件試算表格式,副檔名是 .ods,常見於 LibreOffice Calc 等開放原始碼辦公室軟體;XLSX 則是 Microsoft Excel 從 Excel 2007 起使用的預設檔案格式,屬於 Office Open XML 規格。兩者都是試算表檔案格式,裡面可以存放同一份統計資料,並不是兩種不同內容的報表。Microsoft Excel 可以開啟與儲存 ODS 檔案,但兩種格式支援的功能不完全相同,互相轉換時,部分格式設定或進階功能可能無法完整保留。本篇要在 Excel 中研究資料,所以直接選擇 XLSX。
選對檔案格式,只代表這份資料可以用 Excel 開啟,並不代表它的內容已經適合所有分析需求。「試算表檔案格式」和「適合資料分析的表格結構」是兩個不同層次的問題:前者決定用什麼軟體打開,後者決定打開之後,資料能不能直接用來篩選、彙總或建立樞紐分析表。這份官方報表接下來要觀察的,正是第二個層次。
三、Excel 資料結構:原始統計報表有哪些特點
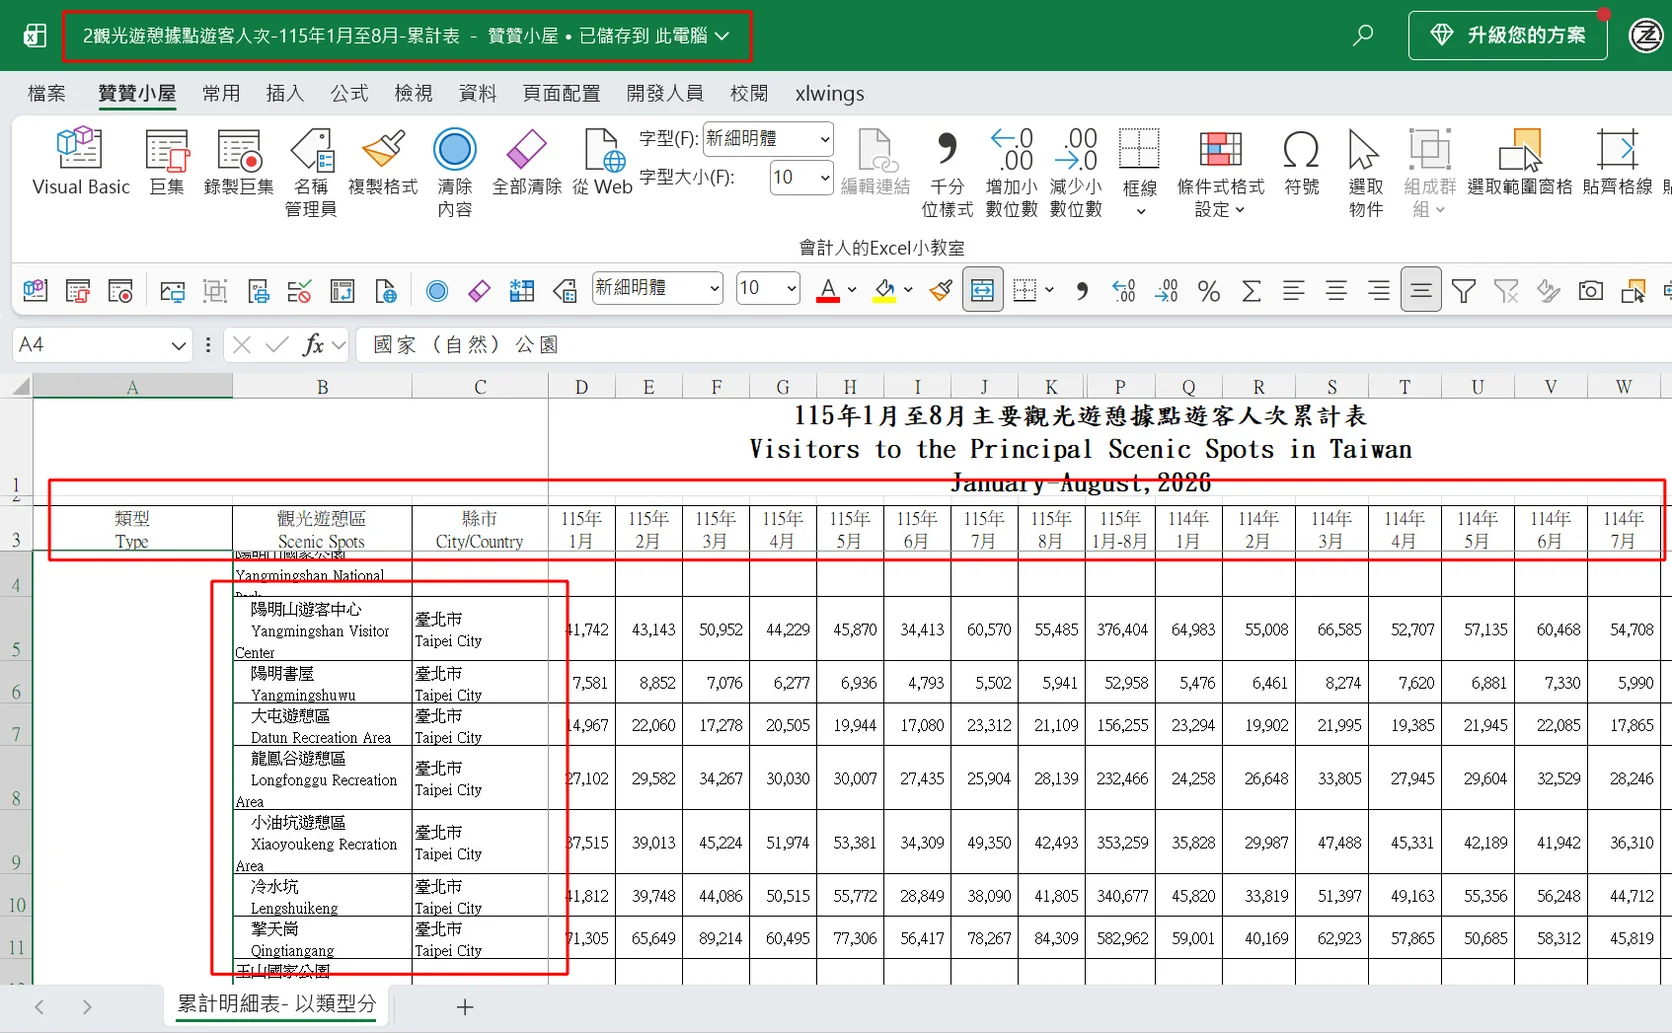
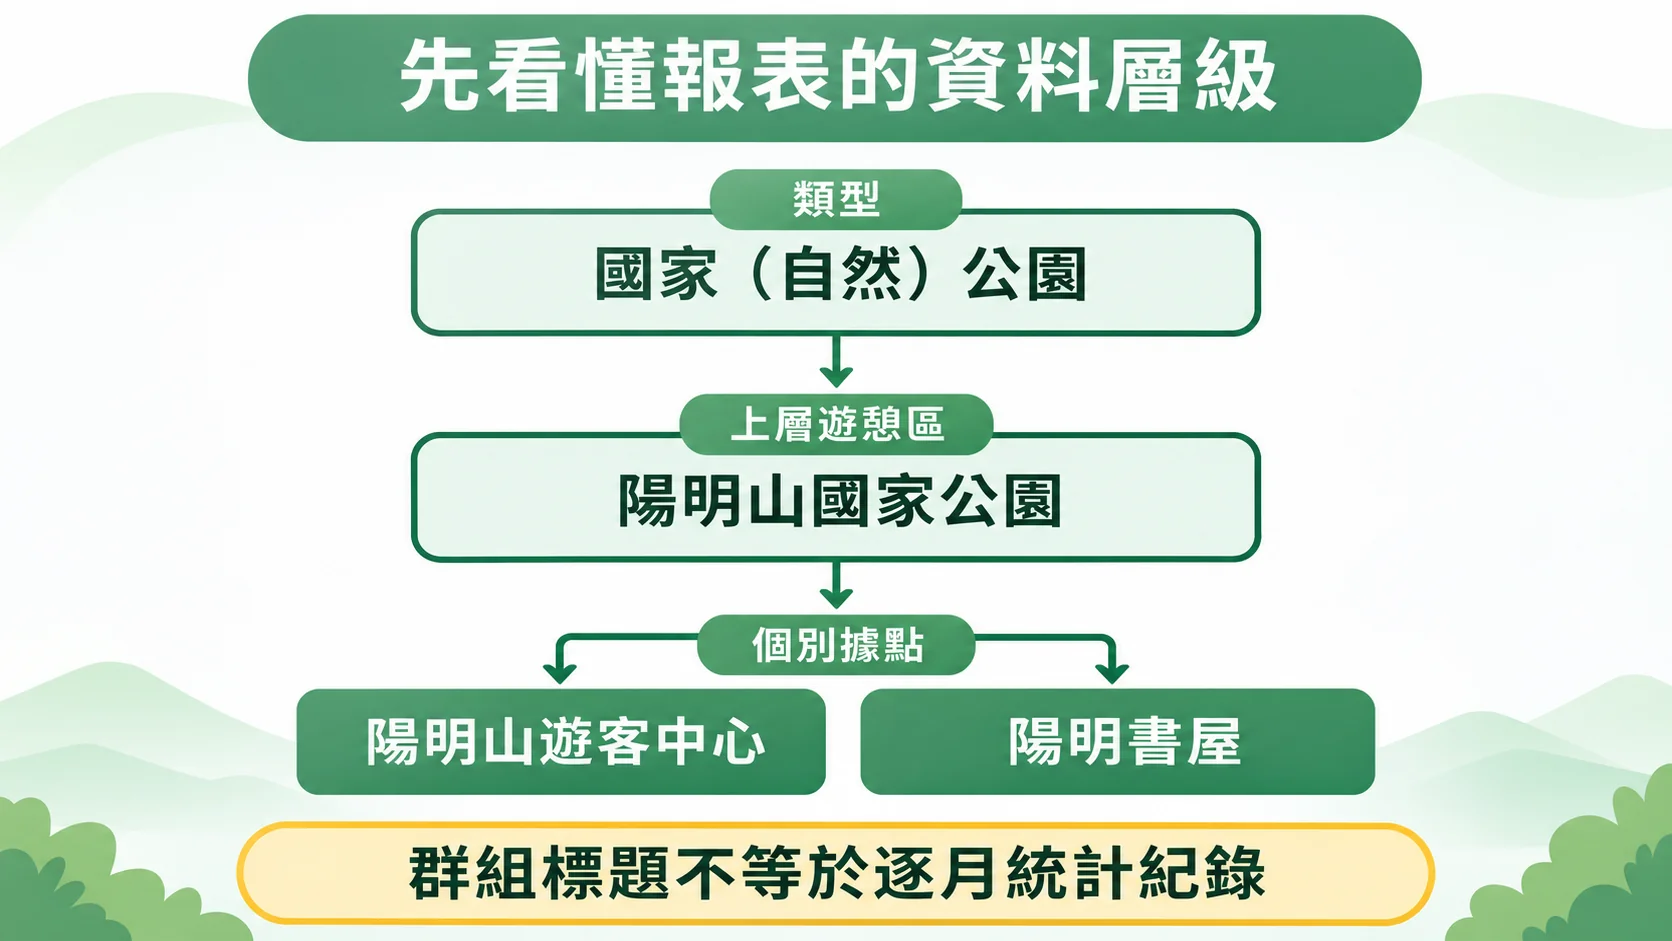
用 Excel 開啟下載的「2觀光遊憩據點遊客人次-115年1月至8月-累計表」,工作表名稱是「累計明細表- 以類型分」。最上方是中英文並列的大標題「115年1月至8月主要觀光遊憩據點遊客人次累計表」與「Visitors to the Principal Scenic Spots in Taiwan」,第 3 列才是欄位標題,依序為「類型 Type」「觀光遊憩區 Scenic Spots」「縣市 City/Country」,接著是「115年1月」到「115年8月」、「115年1月-8月」的累計欄,再往右是「114年1月」「114年2月」等前一年度的月份資料。A 欄的「國家(自然)公園」是跨越多列的合併儲存格;B 欄第 4 列是「陽明山國家公園」,第 5 列到第 11 列才是陽明山遊客中心、陽明書屋、大屯遊憩區、龍鳳谷遊憩區、小油坑遊憩區、冷水坑、擎天崗等個別據點,每一格都有中文名稱與英文名稱,C 欄縣市同樣是「臺北市」與「Taipei City」上下兩行,第 12 列又換成下一個群組「玉山國家公園」。
這樣的設計是為了閱讀。合併儲存格讓類型一目了然,群組名稱把同一個遊憩區的據點放在一起,中英文並列方便不同讀者使用,今年與去年的月份並排,也能直接比較同月份的人次。贊贊小屋第一眼看到這份檔案時,覺得它其實是一份很規範的資料;真正的問題不是資料混亂,而是它已經有既定的報表表達方式,換一個角度分析時就不太方便。
要理解「不方便」在哪裡,可以先認識兩個基本概念:紀錄(Record)與欄位(Field)。在適合分析的資料表中,每一列是一筆紀錄,代表同一種統計單位;每一欄是一個欄位,代表一種固定意義的資料,例如名稱、縣市或人次。這份報表的列卻不只一種身分:第 4 列「陽明山國家公園」是上層的觀光遊憩區,沒有月份數字,第 5 列以下才是實際統計遊客人次的據點。兩者屬於不同的統計單位,不能直接視為同一層級的紀錄;同樣地,陽明山遊客中心、陽明書屋都隸屬陽明山國家公園,也不代表資料重複。看懂每一列代表什麼,是整理資料之前最重要的一步。
四、ChatGPT 免費版:上傳 Excel 分析資料
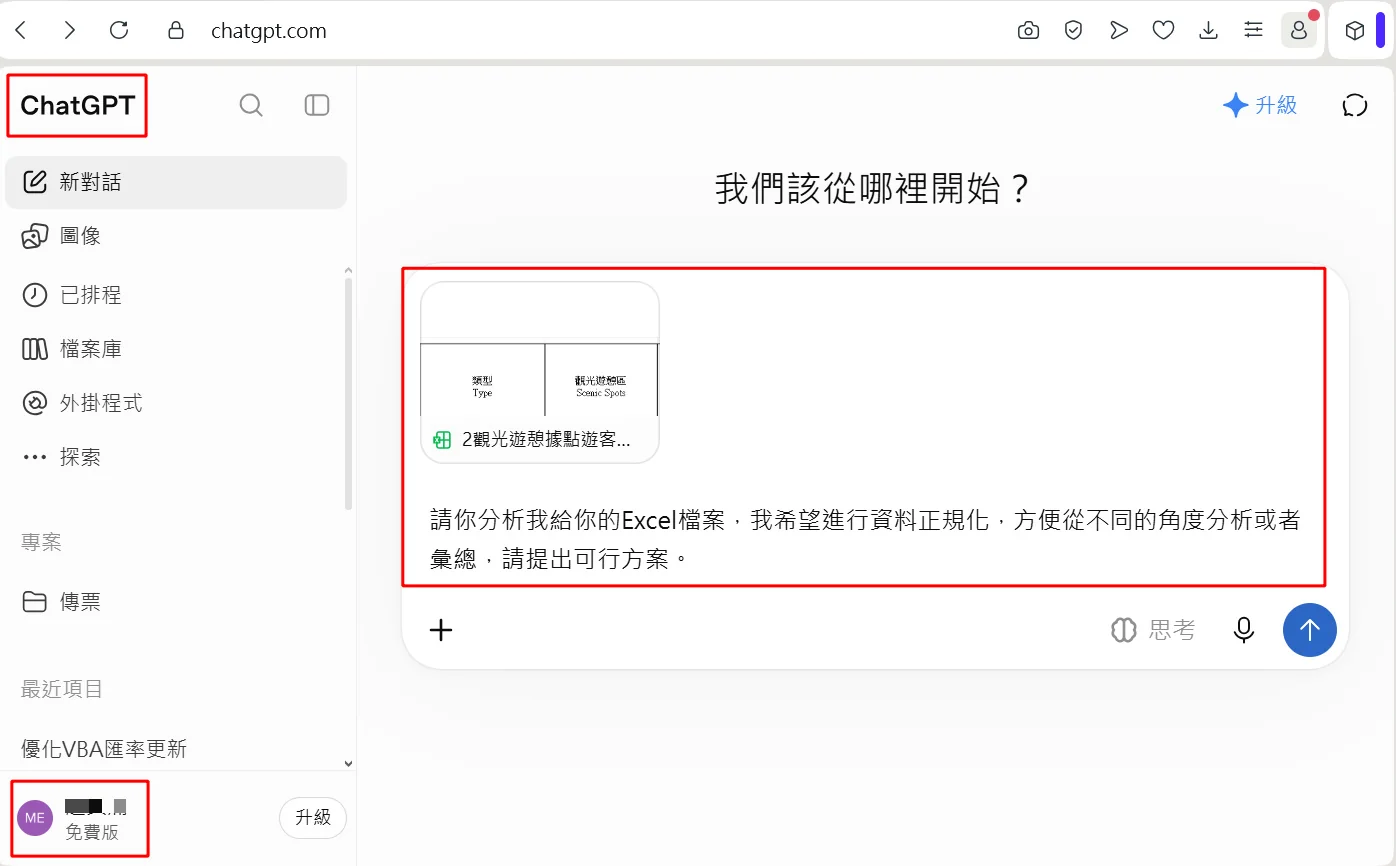
接下來,贊贊小屋打開 ChatGPT,畫面左下角的帳號顯示「免費版」。在「我們該從哪裡開始?」的新對話中,先把剛才下載的 Excel 檔案加入輸入框,接著在檔案下方輸入以下提示詞後送出:
提示詞請你分析我給你的Excel檔案,我希望進行資料正規化,方便從不同的角度分析或者彙總,請提出可行方案。
這次使用的就是一般人都能註冊的 ChatGPT 免費版,不需要付費,也不需要先學程式語言,只要把檔案交給 AI,用自然語言說明想做什麼,就可以開始分析一份實際的政府統計報表。
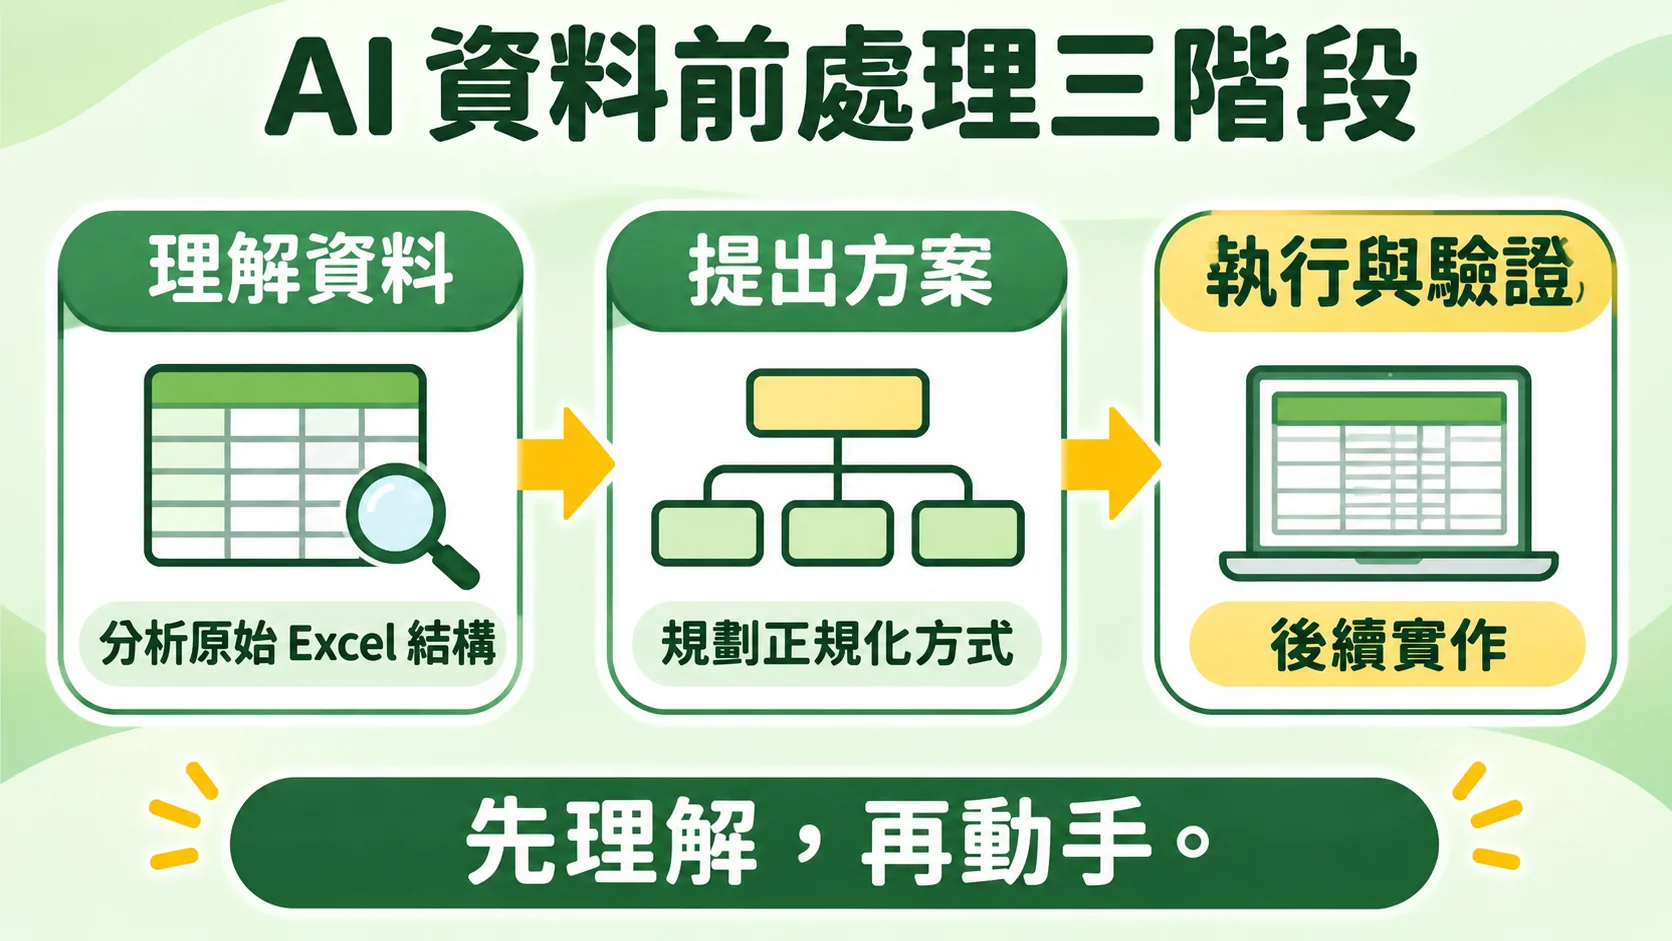
這段提示詞值得注意的地方,是它只說明目的,沒有要求 AI 立刻產生新檔案。提示詞包含三個重點:分析這份 Excel、希望進行資料正規化、方便從不同角度分析或彙總,最後請 AI「提出可行方案」。AI 協助資料前處理時,比較穩妥的順序是先理解資料,再設計整理方式,最後才實際執行與驗證。先讓 AI 說明它看到的結構與建議,使用者可以確認 AI 是否正確理解每一列、每一欄代表什麼,再決定下一步,避免 AI 誤解表格之後直接刪錯資料、漏掉欄位或重複計算。即使沒有資料庫設計的背景,也可以用這種方式,先讓 AI 把專業問題說清楚。
五、正規化意思:為什麼 Excel 資料需要正規化?
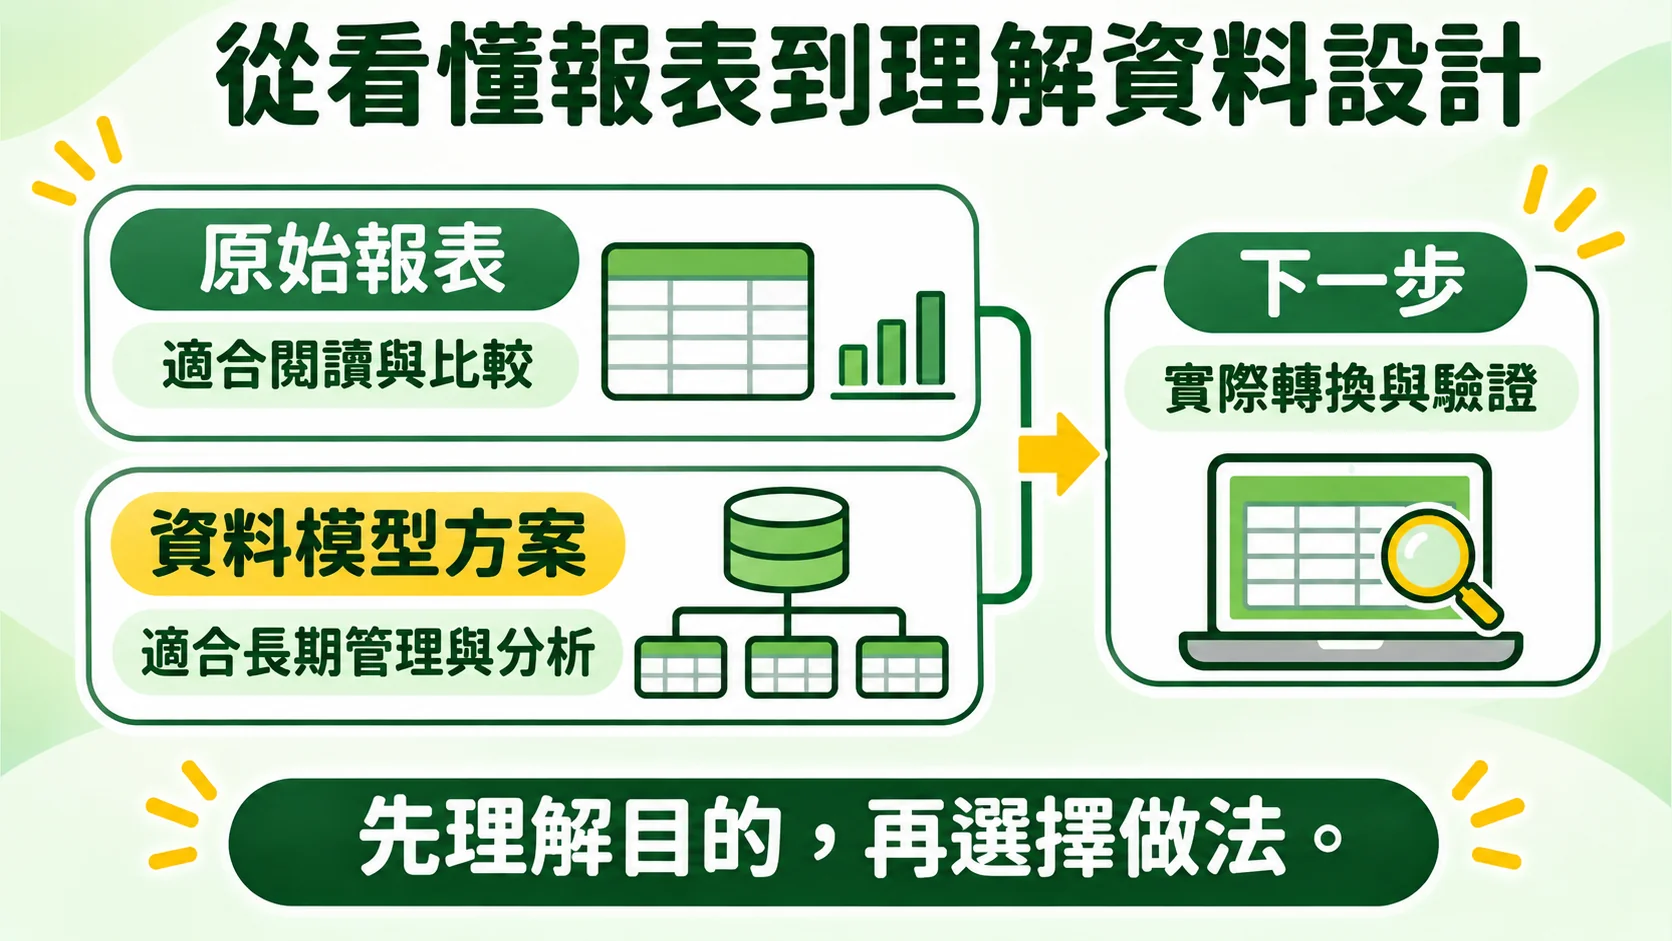
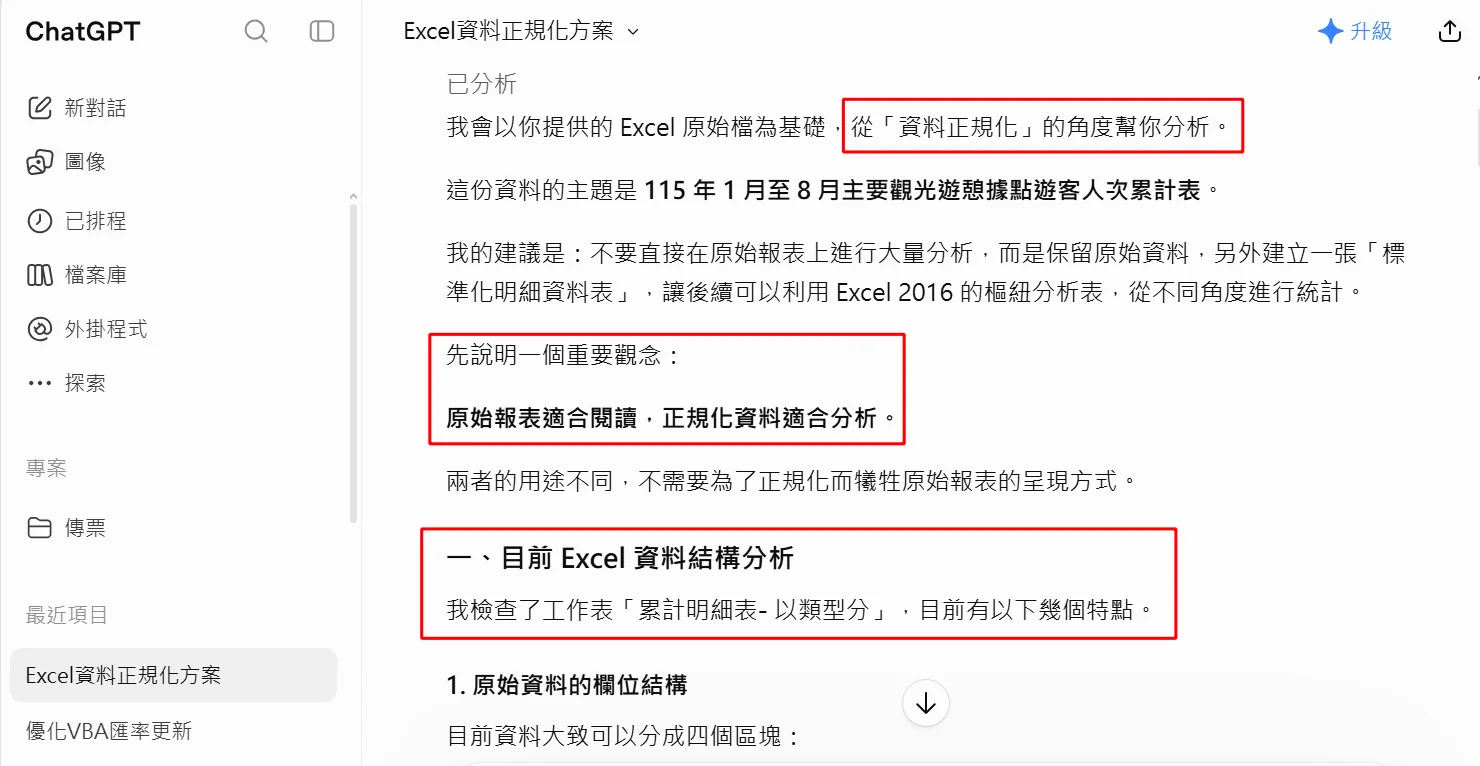
ChatGPT 在對話中顯示「已分析」,接著回覆會以這份 Excel 原始檔為基礎,「從『資料正規化』的角度」進行分析,並辨識出資料主題是「115 年 1 月至 8 月主要觀光遊憩據點遊客人次累計表」。它的第一個建議,是不要直接在原始報表上進行大量分析,而是保留原始資料,另外建立一張「標準化明細資料表」,讓後續可以利用 Excel 2016 的樞紐分析表,從不同角度進行統計。接著 ChatGPT 特別說明一個重要觀念:「原始報表適合閱讀,正規化資料適合分析。」兩者的用途不同,不需要為了正規化而犧牲原始報表的呈現方式。回覆的下一段「一、目前 Excel 資料結構分析」,則說明它檢查了工作表「累計明細表- 以類型分」,開始逐項整理資料的特點。
這句話也點出了正規化的意思。資料庫正規化(Database Normalization)是關聯式資料庫設計的方法,依照資料之間的相依關係,安排資料表、鍵值與欄位,盡量讓同一項資料只保存在一個地方。這樣做的目的,是減少不必要的重複資料,並避免資料之間出現不一致:當景點名稱只記錄在一個地方,要修改時只需要改一次;如果同一個名稱散落在數百筆紀錄裡,就可能改了一部分、漏了一部分。換句話說,正規化是一種資料結構的設計思維,不是單純把表格排列整齊。
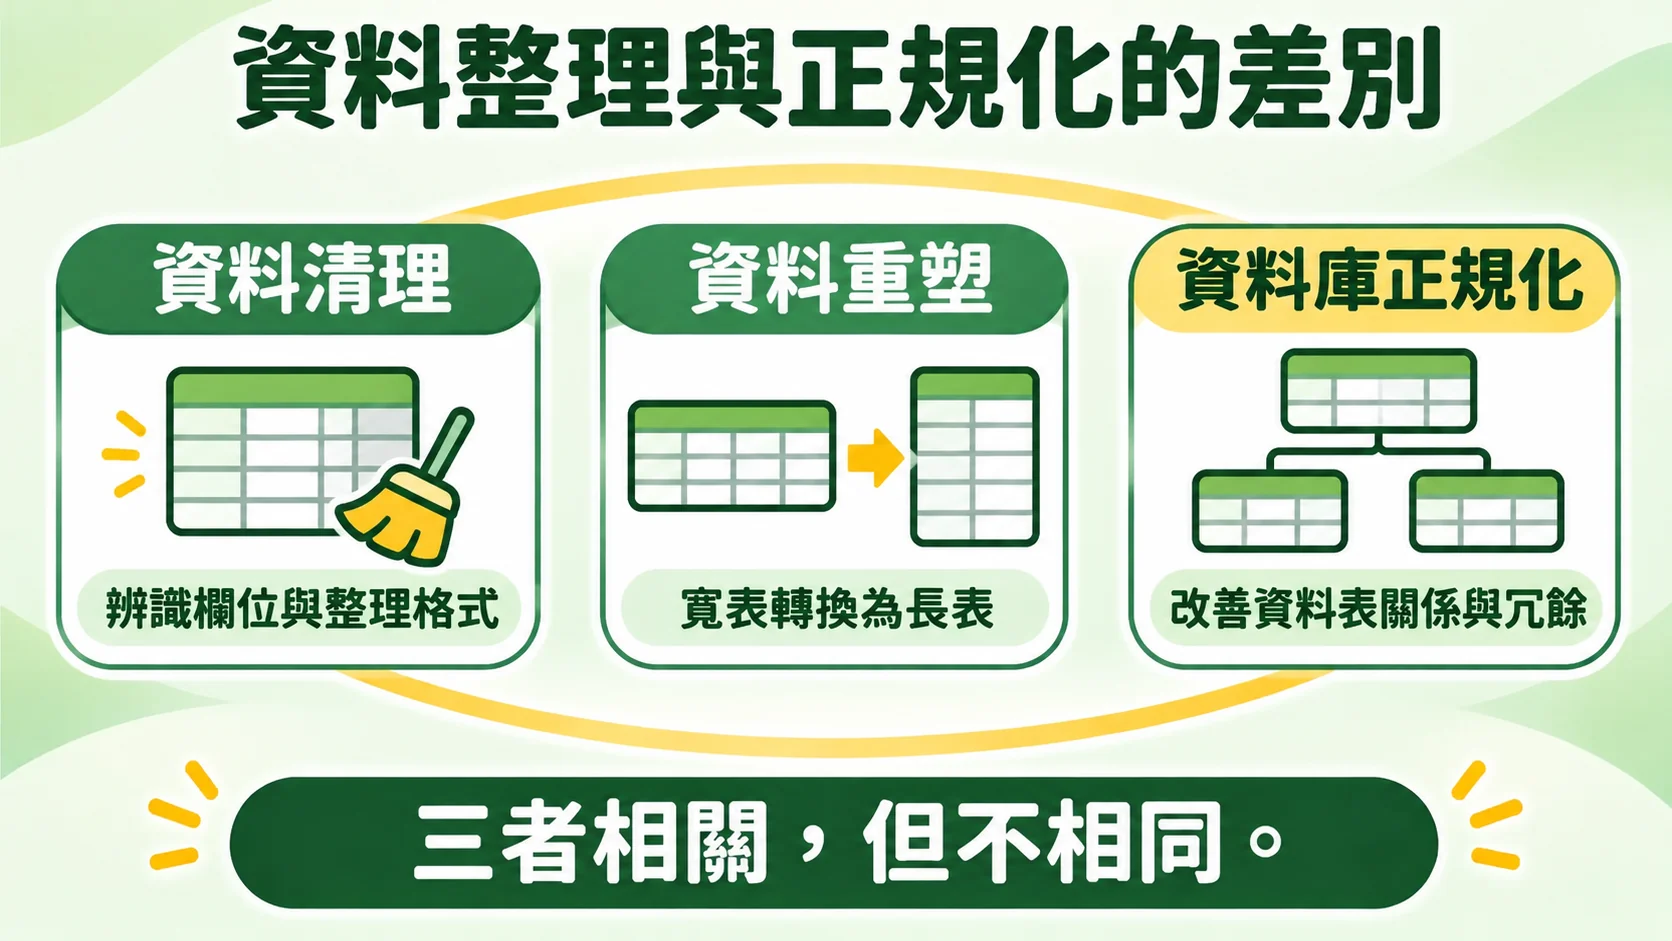
在這次的案例中,其實同時牽涉三件不同性質的工作。第一是資料清理,例如辨識標題列與群組列、處理合併儲存格與中英文並列的欄位,贊贊小屋過去整理 Excel 健保級距表時遇到的合併儲存格與空白字元,也屬於這一類;第二是資料重塑,也就是把橫向排列的月份改成逐筆紀錄;第三才是資料庫正規化,也就是把重複使用的景點基本資料與持續增加的統計數字分成不同資料表。三者常常一起出現,但不應全部混稱為正規化。
這也表示,並不是所有 Excel 報表都必須進行資料庫正規化。一份只用來閱讀或列印的報表,維持原本的版面反而最清楚;當資料需要每個月持續累積、跨年度比較,或者要與其他資料建立關聯、從不同角度反覆彙總時,正規化的價值才會明顯出現。觀光署的這份報表每個月都會更新,也有人想依年度、月份與據點自由分析,正好落在後者。
六、Excel 正規化問題:月份與年度的資料結構
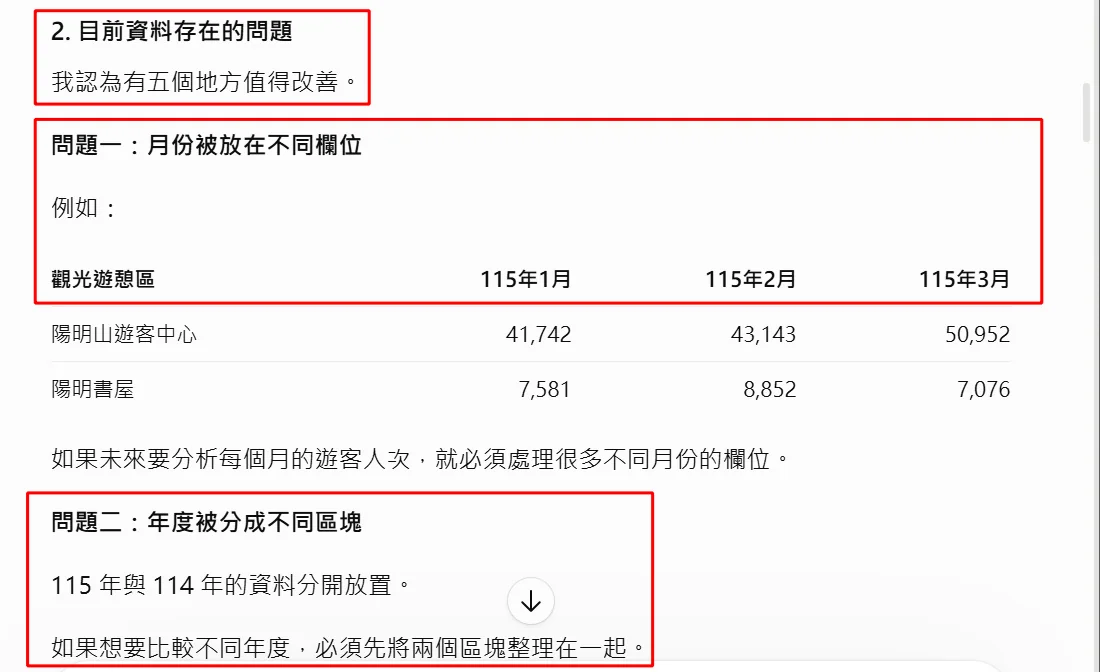
ChatGPT 繼續在「2. 目前資料存在的問題」中表示,它認為有五個地方值得改善。第一個是「問題一:月份被放在不同欄位」,它以「115年1月」「115年2月」「115年3月」三欄為例,列出陽明山遊客中心的 41,742、43,143、50,952,以及陽明書屋的 7,581、8,852、7,076,並說明如果未來要分析每個月的遊客人次,就必須處理很多不同月份的欄位。第二個是「問題二:年度被分成不同區塊」,115 年與 114 年的資料分開放置,如果想比較不同年度,必須先將兩個區塊整理在一起。這兩項都可以在原始檔案中直接核對:月份與年度確實都是以欄位標題的方式橫向展開。
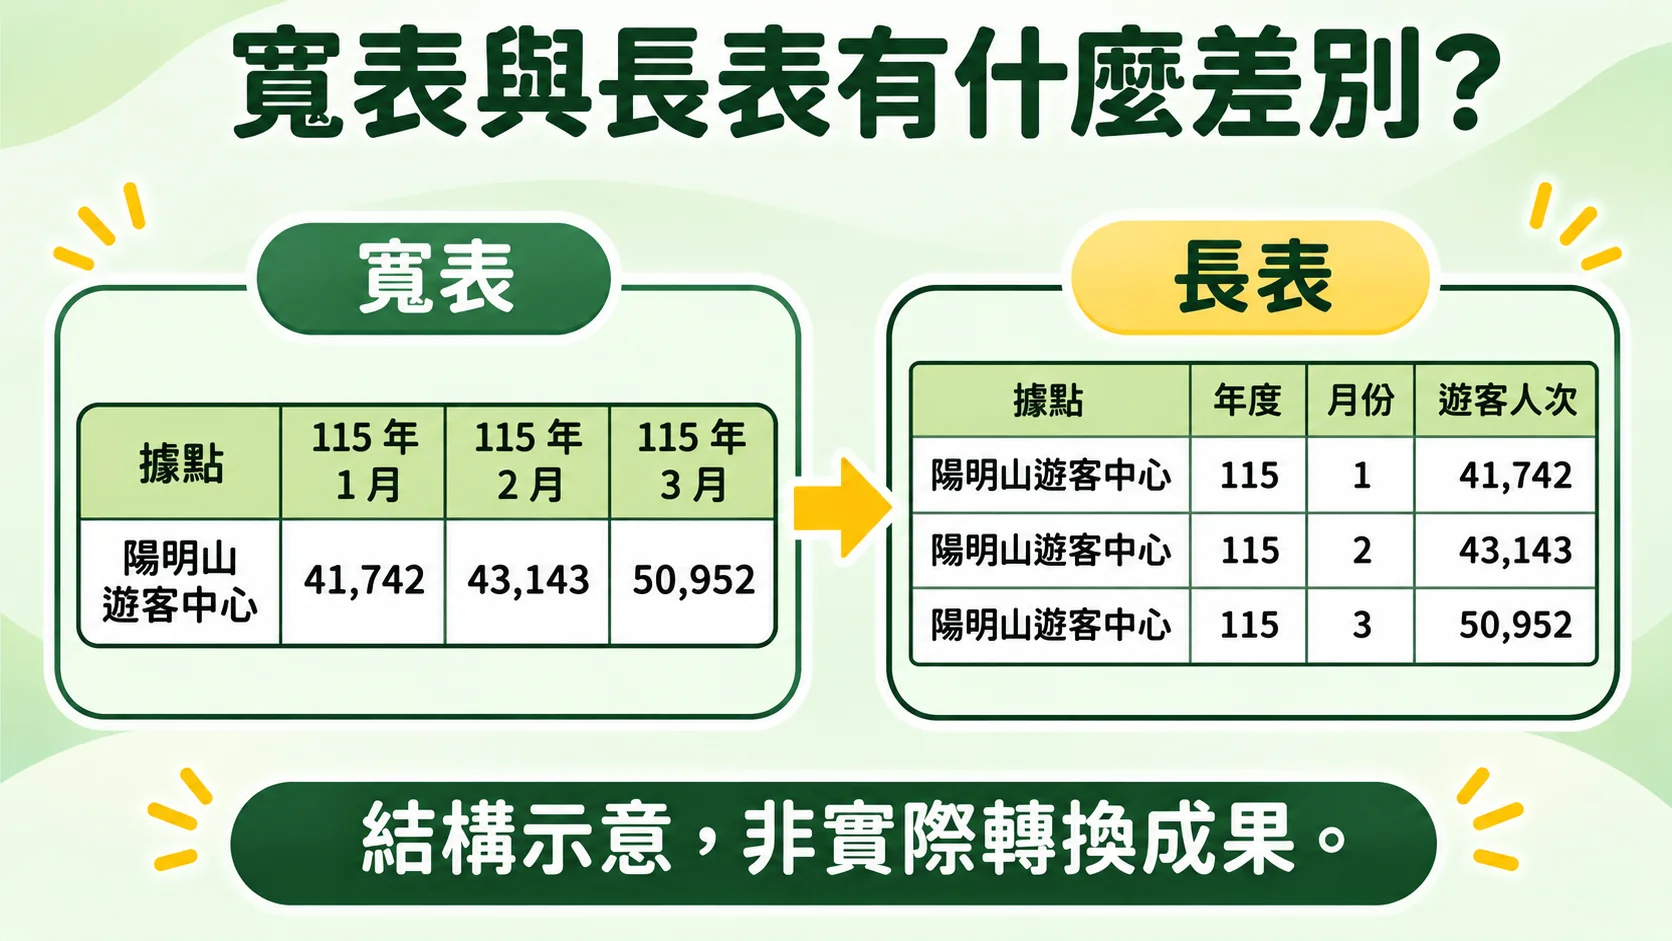
ChatGPT 指出的情形,就是寬表格(Wide Format)與長表格(Long Format)的差別。寬表格把同一個變數的不同取值放成不同欄位,例如「115年1月」「115年2月」……「114年1月」,每一欄其實都是「年度+月份」這個變數的一個值;長表格則把它們拆成「年度」「月份」「遊客人次」三個欄位,每個據點在每個年度、每個月份各占一列。寬表格適合人閱讀,一眼就能看到同一個據點各月份的變化;長表格的列數雖然變多,卻更適合交給 Excel 篩選、排序與建立樞紐分析表。
長表格最大的好處,是新增資料時結構不必改變。寬表格每多一個月份就要多一欄,每多一個年度就要多一整個區塊,相關公式與樞紐分析表的資料範圍也得跟著調整;長表格只是在下方增加新的紀錄,欄位永遠是同樣幾個。這份報表每個月都會更新,如果要長期累積多年的資料,逐筆紀錄的結構顯然比較容易維護。
另外,「115年1月-8月」這種累計欄位,也需要和單月人次分開看待。累計數字是由各月份加總而來的另一種統計值,如果把它和單月人次放進同一個數值欄位,一起加總時就會重複計算;它比較適合保留下來,作為驗證整理結果是否正確的對照數字。
七、資料表關聯:觀光據點主檔與遊客人次明細表
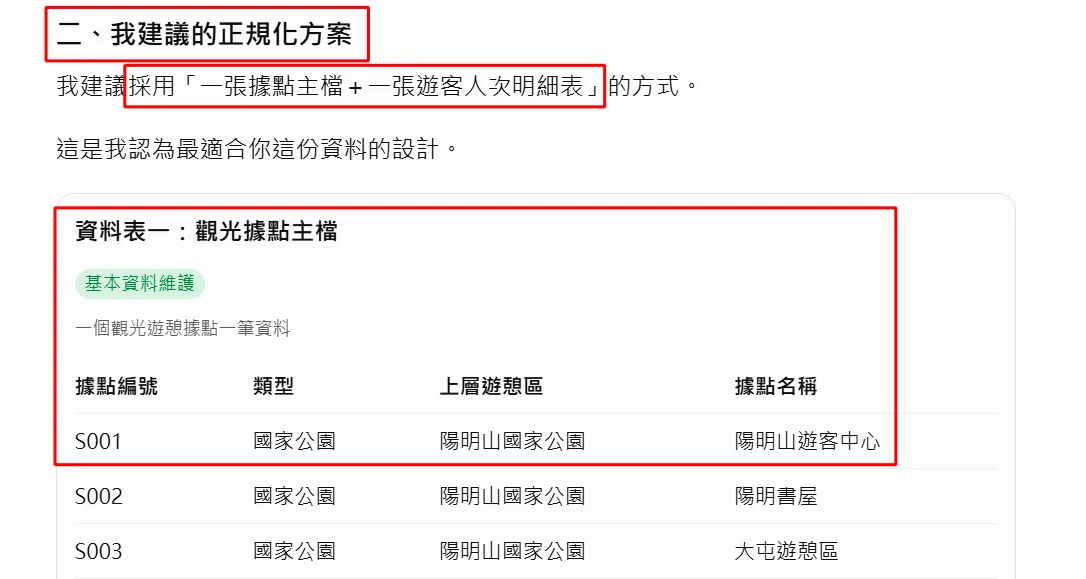
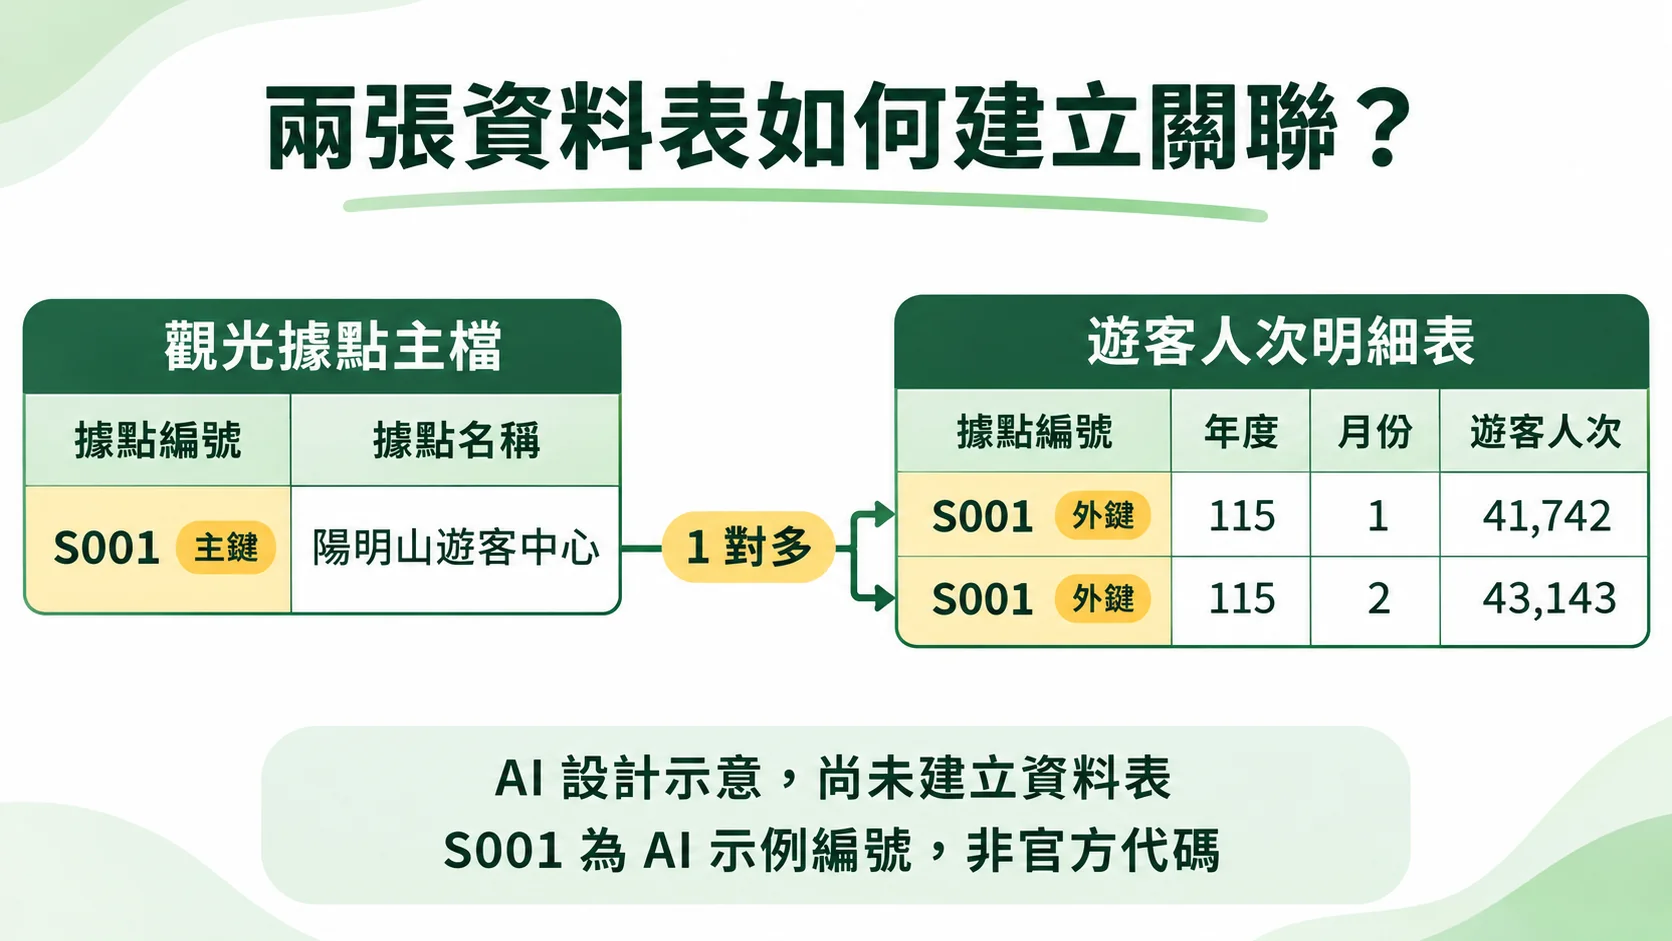
在「二、我建議的正規化方案」中,ChatGPT 建議採用「一張據點主檔 + 一張遊客人次明細表」的方式,並表示這是它認為最適合這份資料的設計。第一張是「資料表一:觀光據點主檔」,標示為「基本資料維護」,說明是一個觀光遊憩據點一筆資料,欄位有「據點編號」「類型」「上層遊憩區」「據點名稱」。示意資料的第一筆是 S001、國家公園、陽明山國家公園、陽明山遊客中心,接著是 S002 陽明書屋與 S003 大屯遊憩區。這裡的 S001、S002 等據點編號,是 AI 為了說明設計而提供的示例,並不是交通部觀光署的官方編碼;示意中的類型寫作「國家公園」,原始報表的類型名稱則是「國家(自然)公園」。
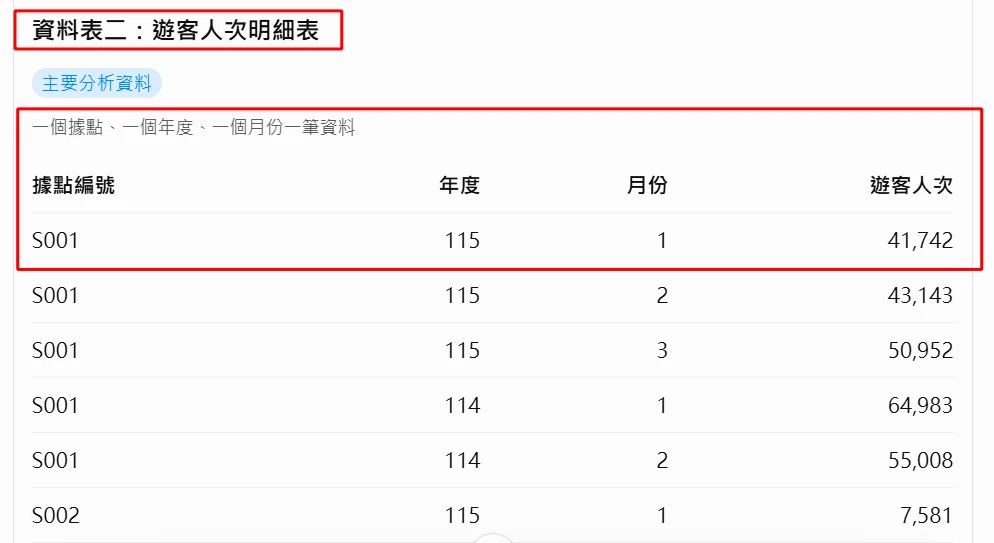
第二張是「資料表二:遊客人次明細表」,標示為「主要分析資料」,說明是一個據點、一個年度、一個月份一筆資料,欄位只有「據點編號」「年度」「月份」「遊客人次」四個。示意資料中,S001 在 115 年 1 月、2 月、3 月分別是 41,742、43,143、50,952,114 年 1 月與 2 月是 64,983 與 55,008,下一筆換成 S002 在 115 年 1 月的 7,581。對照原始報表,這些數字正是陽明山遊客中心與陽明書屋的月份人次,只是從橫向的月份欄位,改成一列一筆的紀錄。
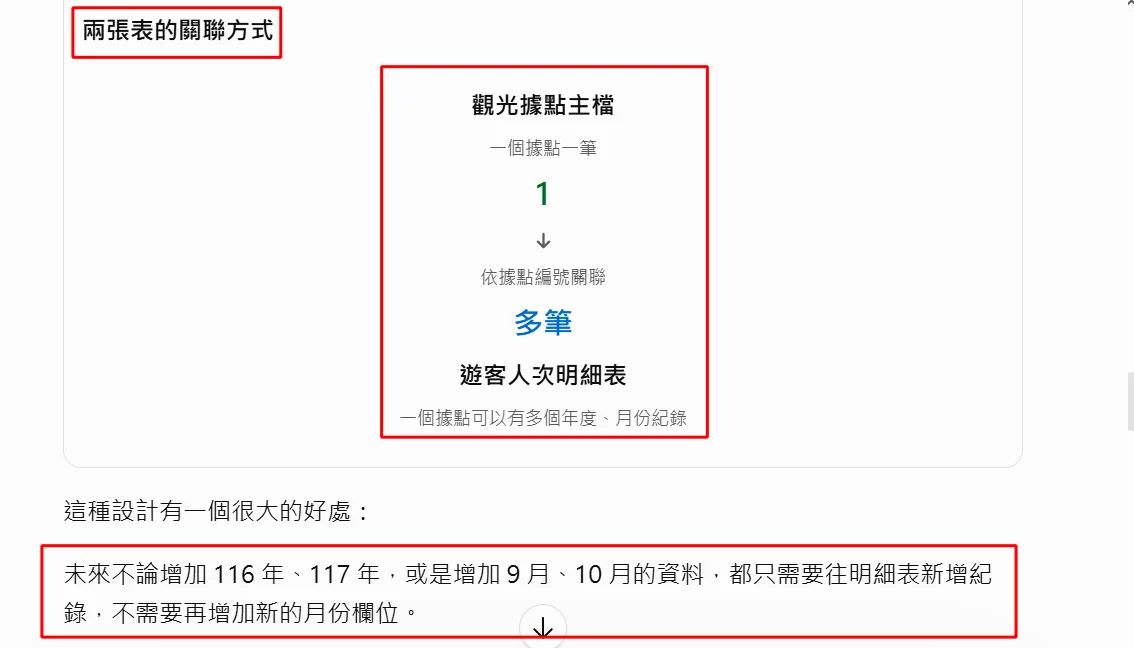
兩張表的關聯方式,ChatGPT 用一個簡單的圖示說明:上方是「觀光據點主檔」,一個據點一筆,標示為「1」;中間寫著「依據點編號關聯」;下方是「遊客人次明細表」,一個據點可以有多個年度、月份紀錄,標示為「多筆」。它最後說明這種設計的好處:未來不論增加 116 年、117 年,或是增加 9 月、10 月的資料,都只需要往明細表新增紀錄,不需要再增加新的月份欄位。
這個方案背後有幾個資料庫的基本概念。觀光據點主檔屬於主檔(Master Data),保存的是相對穩定、會被重複使用的基本資料;每個據點只記錄一次,名稱或分類需要修改時,只改主檔的一筆即可。用來辨識每一筆主檔資料的欄位稱為主鍵(Primary Key),這裡就是據點編號,同一個編號只能對應一個據點。使用編號而不是名稱當作識別依據,可以避免名稱調整或不同地點同名時造成混淆,但編號需要有穩定的分配規則,不能每次重新整理就重新編號。
遊客人次明細表則是隨時間不斷增加的明細資料,每一筆代表「某個據點、某個年度、某個月份」的遊客人次。單看據點編號、年度或月份,都無法辨識唯一的一筆紀錄;如果規定同一據點在同一年同一月只能有一筆資料,那麼「據點編號+年度+月份」三個欄位合起來,就可以共同成為這張表的唯一識別條件,也就是複合鍵(Composite Key)的概念。
明細表裡的據點編號,用來對應主檔中的據點編號,這種欄位稱為外鍵(Foreign Key)。主檔的一筆據點,可以對應明細表中許多筆不同年度與月份的紀錄,這就是一對多關聯。建立關聯之後,明細表中出現的每一個據點編號,都應該能在主檔中找到對應的據點;如果明細表有 S999,主檔卻沒有 S999,這筆人次就不知道屬於哪裡。維持兩張表之間的對應關係,稱為參照完整性(Referential Integrity)。需要特別說明的是,這兩張資料表目前是 ChatGPT 提出的設計方案,畫面中的資料也只是示意,還不是已經產生並驗證完成的 Excel 資料表。
八、正規化步驟:第一、第二、第三正規化是什麼?
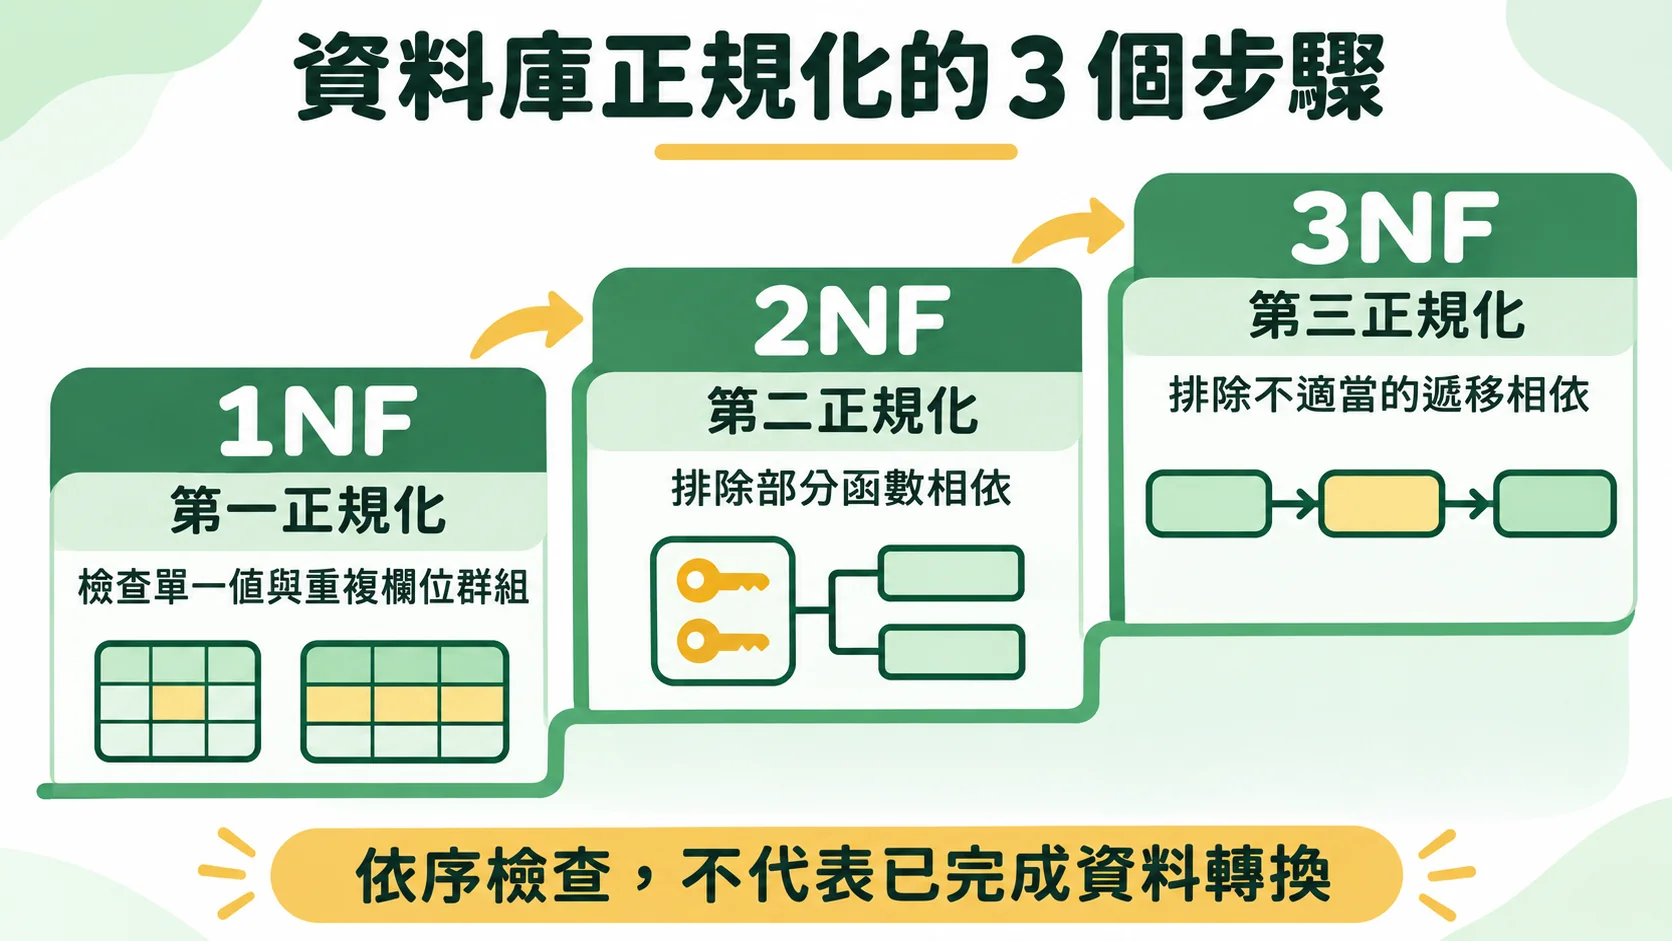
看完 ChatGPT 的兩張資料表方案,再回頭理解資料庫正規化的基本步驟,就容易多了。正規化的步驟,通常從第一正規化開始,依序檢查到第三正規化,每一個步驟都建立在前一個步驟的基礎上。以下沿用同一份觀光景點資料,簡單說明三個步驟各自在處理什麼問題。
第一步:第一正規化(1NF)
第一正規化要求資料表中的每個欄位只保存單一的值,不在同一格裡放進一串資料;同一類資料也不應該以重複的欄位群組反覆出現,而且每一筆紀錄都要能以主鍵唯一識別。Microsoft 與 IBM 的資料庫說明,都把「用好幾個欄位存放同一類資料」視為第一正規化要排除的重複群組。原始報表把「115年1月」到「115年8月」、「114年1月」以後的月份排成一整排欄位,也呈現這種重複月份欄位的設計特徵;改成「年度」「月份」「遊客人次」逐筆記錄之後,月份不再是一欄一欄往右延伸,而是成為一個欄位的不同值。同樣地,景點名稱若需要分別使用中文與英文,也可以考慮拆成兩個欄位。
不過,把寬表轉成長表是一種資料重塑的操作。從比較嚴格的關聯式理論來看,月份分成不同欄位、每一格只存一個數字的寬表,不一定就等於違反第一正規化;轉成長表有助於整理出符合第一正規化的結構,但不能單憑資料變成長表格,就認定整張表已經完整符合第一正規化,仍然需要確認每個欄位的意義與每筆紀錄的識別方式。
第二步:第二正規化(2NF)
第二正規化的前提是已經符合第一正規化,再進一步要求:不屬於鍵值的欄位,必須完整依賴整個候選鍵,而不是只依賴其中一部分。假設把所有資料都放在同一張長表格裡,欄位包含據點編號、年度、月份、據點名稱、類型、上層遊憩區與遊客人次,假設同一據點在同一年同一月只有一筆統計,這張表就要用「據點編號+年度+月份」才能辨識一筆紀錄。遊客人次確實需要三個欄位一起決定;但據點名稱、類型與上層遊憩區只由據點編號決定,和年度、月份無關,這就是部分相依。
部分相依造成的結果,是同一個據點名稱在每個月份的紀錄裡都要重複寫一次。第二正規化的做法,就是把只依賴據點編號的欄位移到另一張以據點編號為主鍵的資料表,這正是 ChatGPT 把據點基本資料放進觀光據點主檔、明細表只保留據點編號的原因。
第三步:第三正規化(3NF)
第三正規化的前提是已經符合第二正規化,再檢查不屬於鍵值的欄位之間,是否存在不適當的遞移相依。遞移相依的意思是:某個欄位不是直接由主鍵決定,而是透過另一個非鍵欄位間接決定。以觀光據點主檔來說,如果未來景點分類除了名稱,還有固定的分類代碼與分類說明,那麼分類說明其實是由分類代碼決定,而不是由據點編號直接決定;這時候就可以評估建立一張分類主檔,避免同一段分類說明在許多據點中重複維護。同樣的檢查方式也適用於主檔中的「上層遊憩區」與「類型」:如果同一個上層遊憩區一定屬於同一個類型,兩者之間就可能存在這種關係。
是否真的需要再拆表,仍然要依資料實際的相依關係與使用需求判斷,不是每個欄位都要拆成獨立的資料表。第三正規化提供的是一種檢查角度,幫助設計者發現那些容易在更新時出現不一致的欄位。
整體來看,第一正規化著重欄位值與基本資料結構,第二正規化處理部分函數相依,第三正規化進一步處理不適當的遞移相依。這三個步驟的目的都是讓資料結構更清楚,減少維護與更新時可能出現的不一致。這裡的說明是以前面的案例幫助理解,並不代表 ChatGPT 提出的兩張資料表已經完整通過第一到第三正規化的檢驗。
從看懂資料結構開始,讓 AI 協助 Excel 資料分析
回到一開始的問題:一份完整、正式,而且已經整理得很好的政府統計報表,為什麼還需要重新設計資料結構?答案並不是原始報表有錯,而是資料的用途改變了。報表是為了讓人閱讀而設計,合併儲存格、群組標題、中英文並列與年度並排,都讓人更容易看懂;當資料要長期累積、跨年度比較,或從不同角度彙總時,原本適合閱讀的設計,就不一定適合分析。
這次贊贊小屋只用 ChatGPT 免費版上傳一份 Excel、輸入一段提示詞,AI 就從報表結構說明了月份與年度的問題,提出觀光據點主檔與遊客人次明細表的設計,也讓主鍵、外鍵、一對多關聯與正規化步驟這些原本偏向資料庫課本的名詞,有了具體的例子可以對照。AI 的價值不只是幫忙操作 Excel,更在於幫助使用者理解原本不熟悉的資料設計觀念,知道為什麼要這樣整理。
理解了正規化的意思與三個基本步驟,下一步才是實際動手:依照這次提出的方案,把原始報表真正轉換成可供分析的 Excel 資料表,並檢查整理前後的數字是否一致。